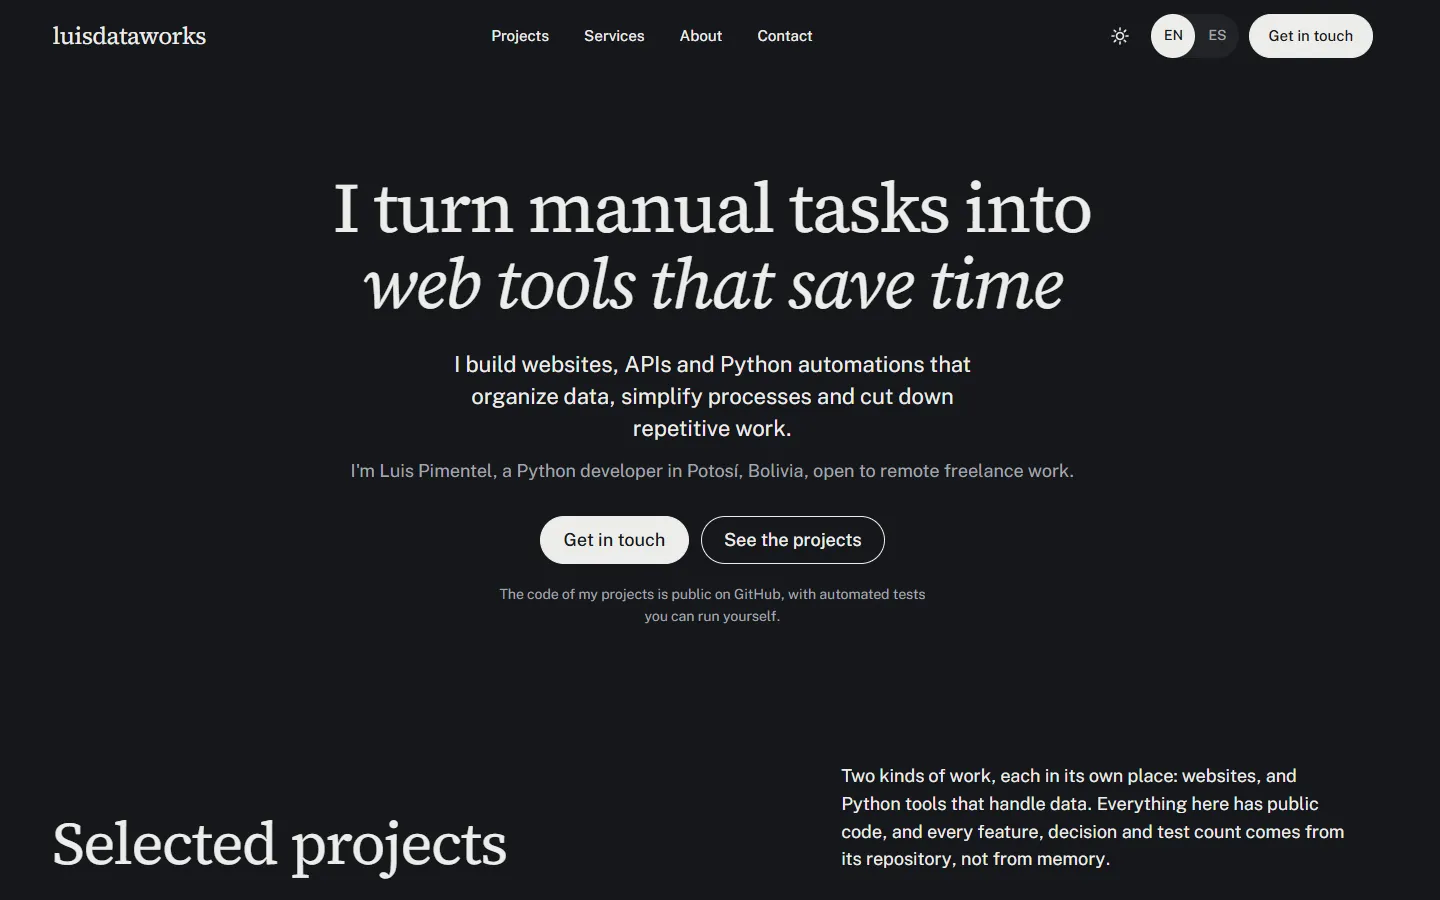
Convierto tareas manuales enherramientas web que ahorran tiempo

Desarrollo páginas web, APIs y automatizaciones en Python para organizar datos, simplificar procesos y reducir trabajo repetitivo.

Soy Luis Pimentel, desarrollador Python en Potosí, Bolivia, disponible para trabajos freelance en remoto.

El código de mis proyectos es público en GitHub, con pruebas automáticas que puedes ejecutar tú mismo.

Proyectos destacados

Dos tipos de trabajo, cada uno en su sitio: sitios web y herramientas en Python que manejan datos. Todo tiene código público, y cada función, decisión y cifra de pruebas sale de su repositorio, no de memoria.

Desarrollo web

Sitios para una persona, un negocio o un producto: el diseño, el contenido y la publicación. Aquí están mi propio sitio y una demo conceptual de cada paquete web.

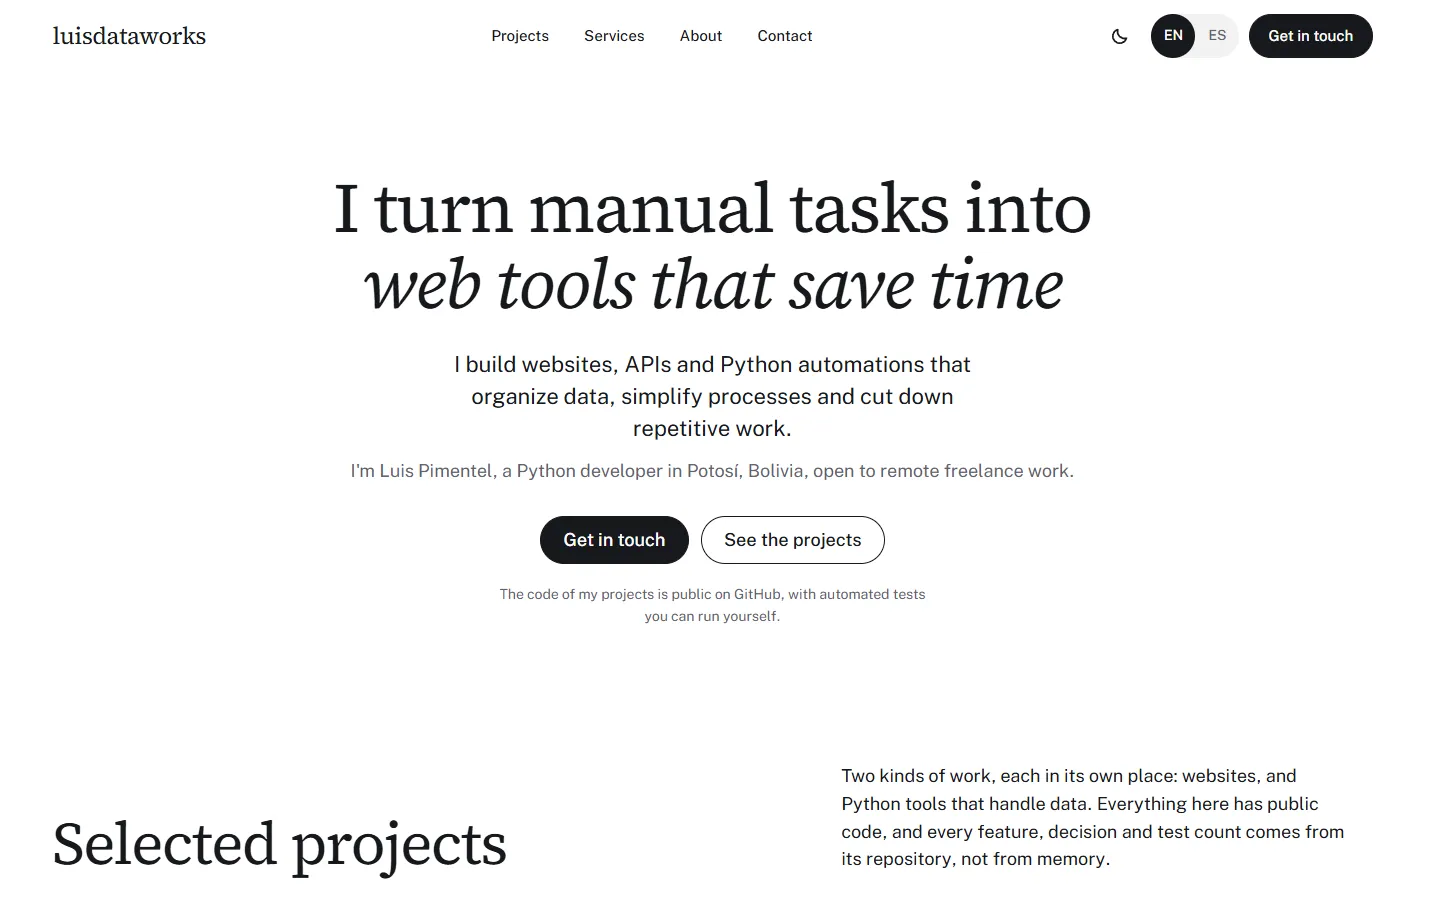
La primera pantalla de este sitio: el titular, una descripción breve y dos botonesLa primera pantalla de este sitio con el tema oscuro
Captura del sitio.

luisdataworks (este sitio)

Propósito

Mi portafolio bilingüe: presenta mis proyectos y servicios y facilita ponerse en contacto.

Qué incluye
  • Versiones en inglés y español, cada una con su propia dirección
  • Tema claro y oscuro que recuerdan la elección del visitante
  • Animaciones que respetan el ajuste de movimiento reducido
  • Sin rastreadores, cookies ni analítica
  • Hecho con Astro y TypeScript, publicado con GitHub Actions en GitHub Pages
Así se ve cada paquete

Una demo conceptual por paquete, cada una un sitio independiente para un negocio ficticio. Cada demo aparece aquí cuando está construida y publicada.

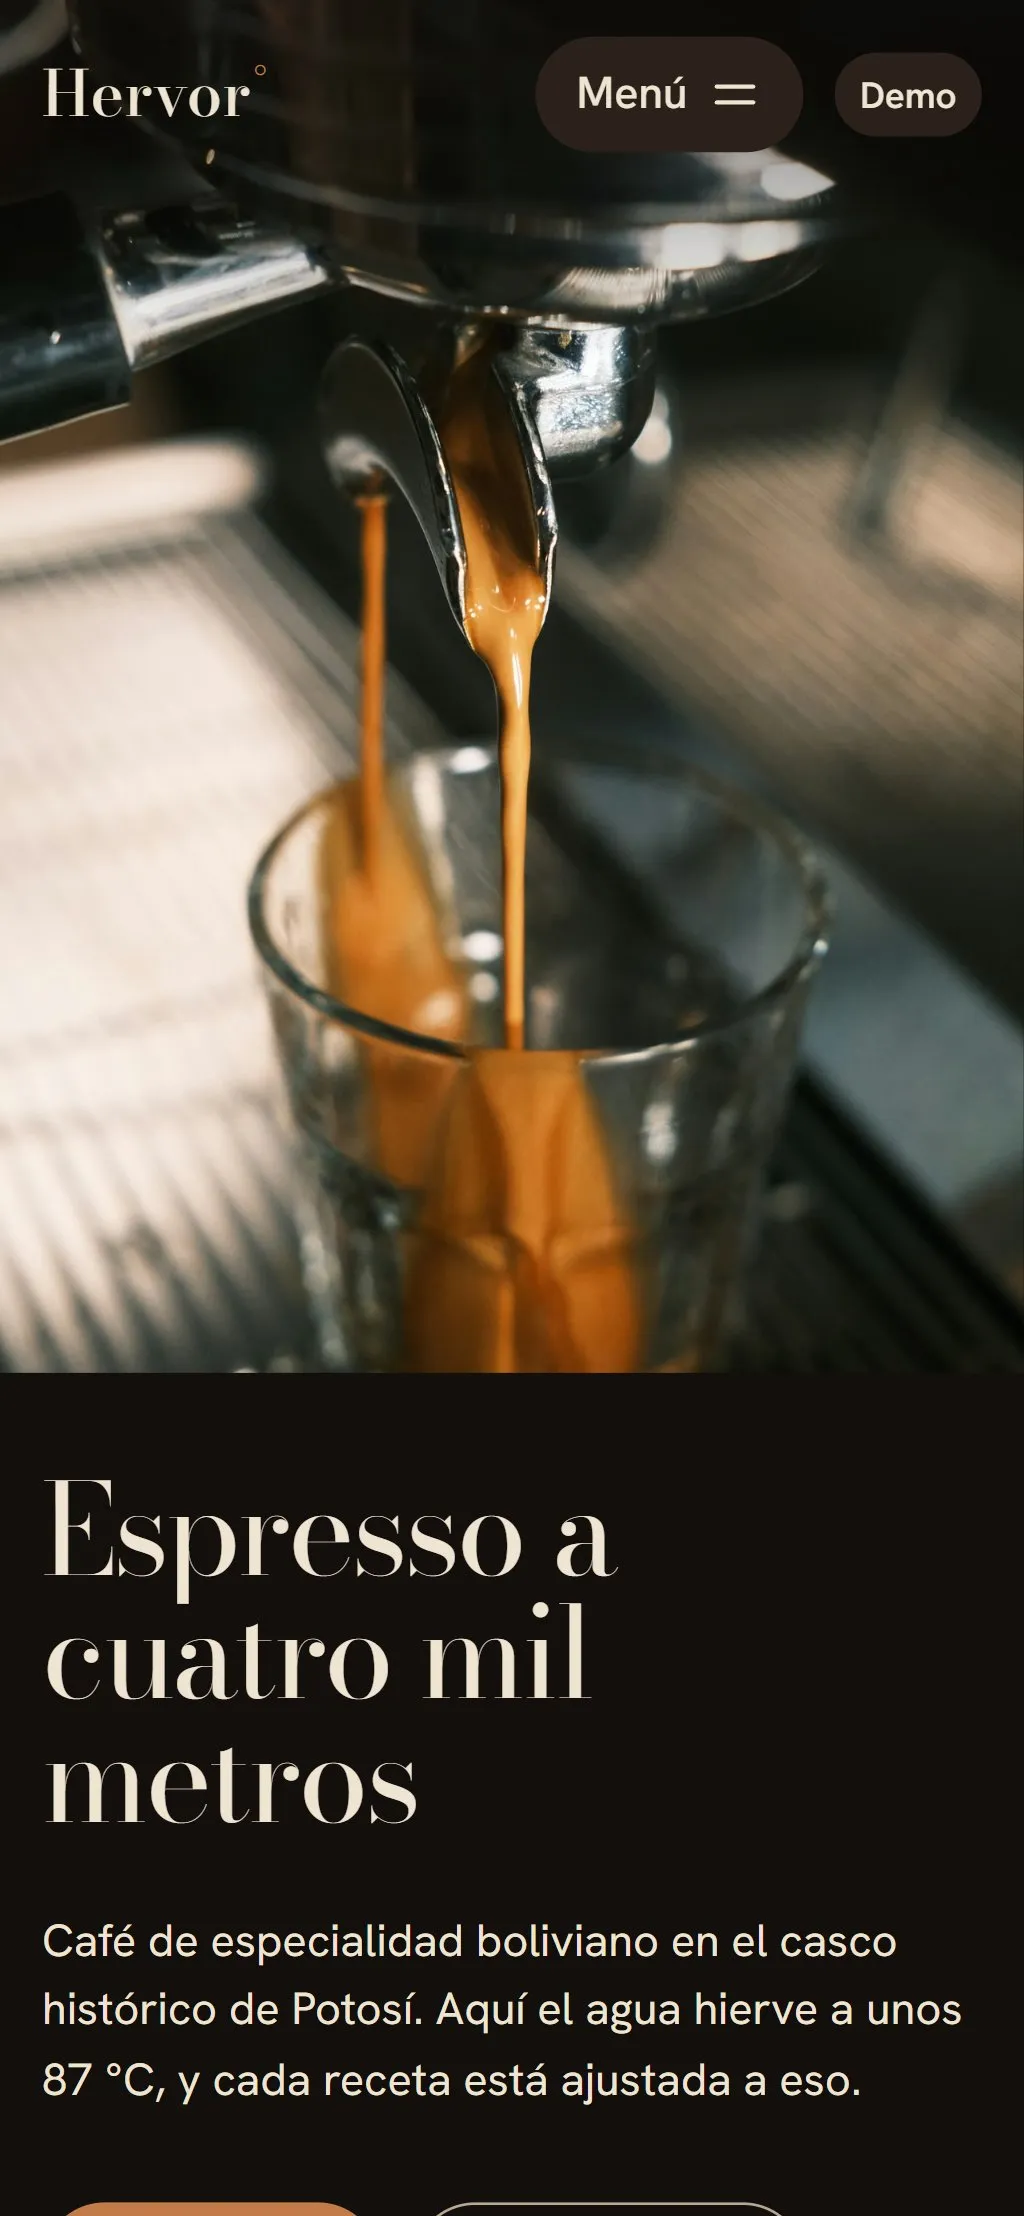
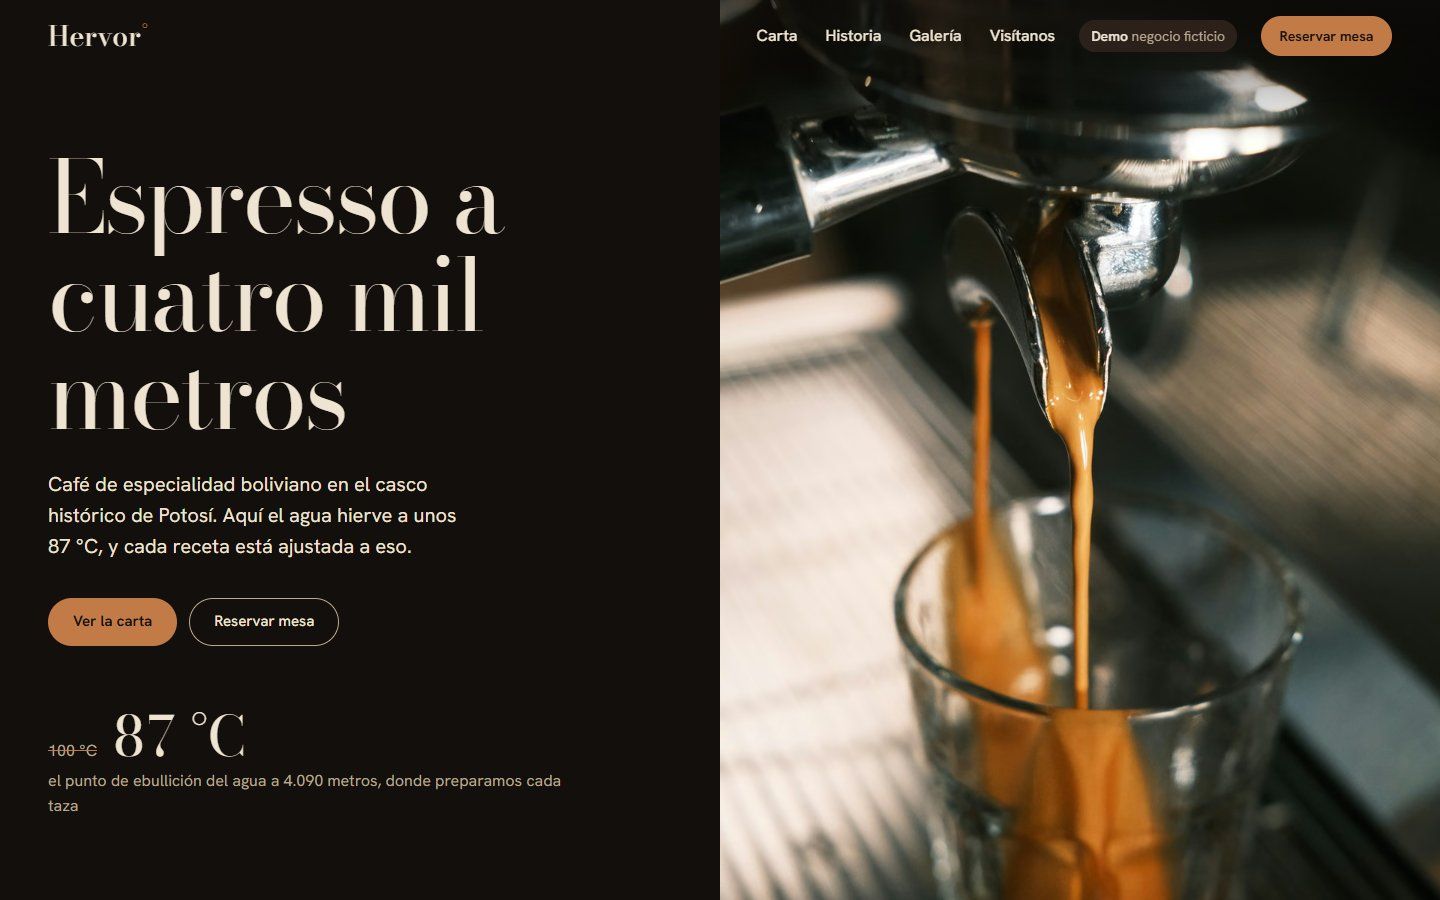
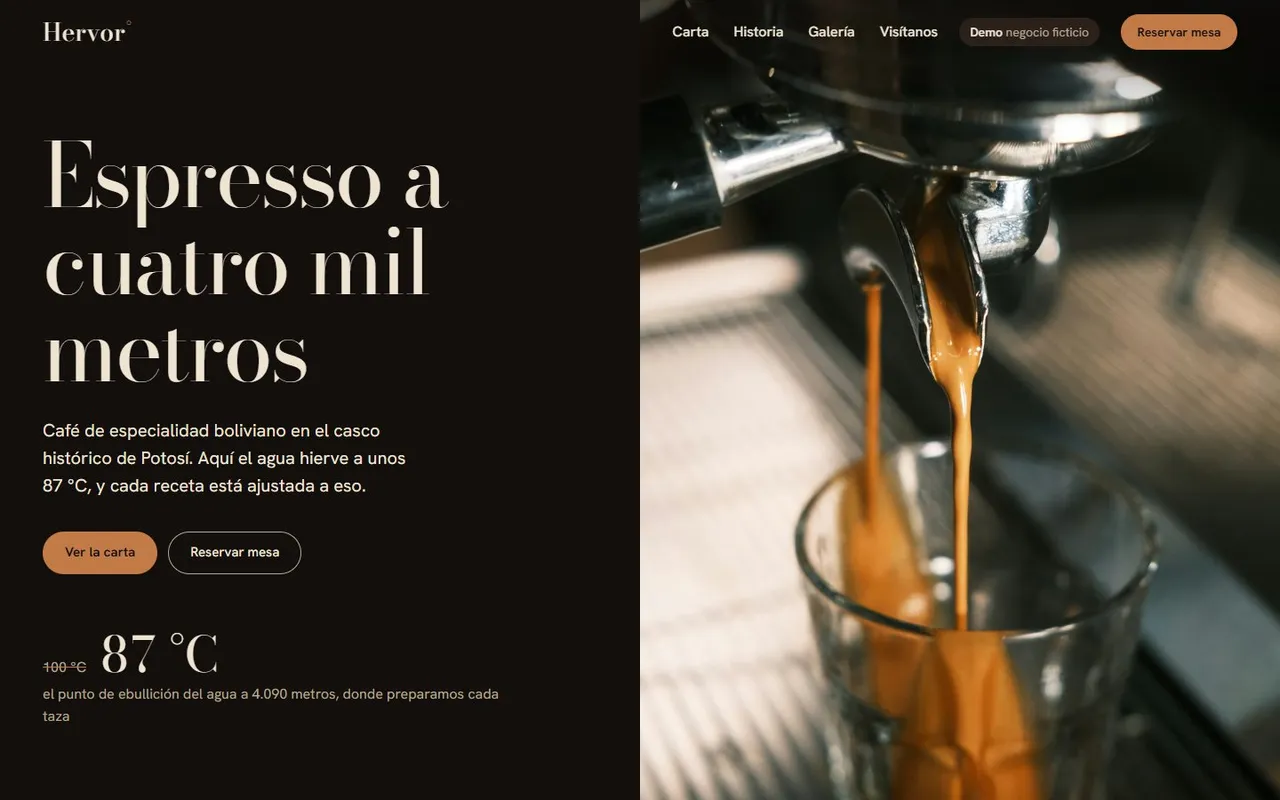
Portada de Hervor: un espresso cayendo en un vaso junto al titular «Espresso a cuatro mil metros» y la temperatura de 87 °C.

Essential

Hervor, café de altura

Cafetería

Demo conceptual: un negocio ficticio

Objetivo

Una web de una sola página para una cafetería ficticia de Potosí: rápida, clara y fácil de usar en el móvil, con todo lo que un cliente busca antes de ir.

Qué muestra
  • Carta en pestañas accesibles: foto, productos y precios por categoría
  • «Abierto ahora / Cerrado», calculado con el horario y la hora de Bolivia
  • Galería con visor: flechas, deslizar con el dedo y cierre con Escape
  • Reserva en cuatro pasos que prepara el mensaje, sin enviar datos
  • Sitio estático: sin servidor, sin cookies ni analítica; funciona sin JavaScript
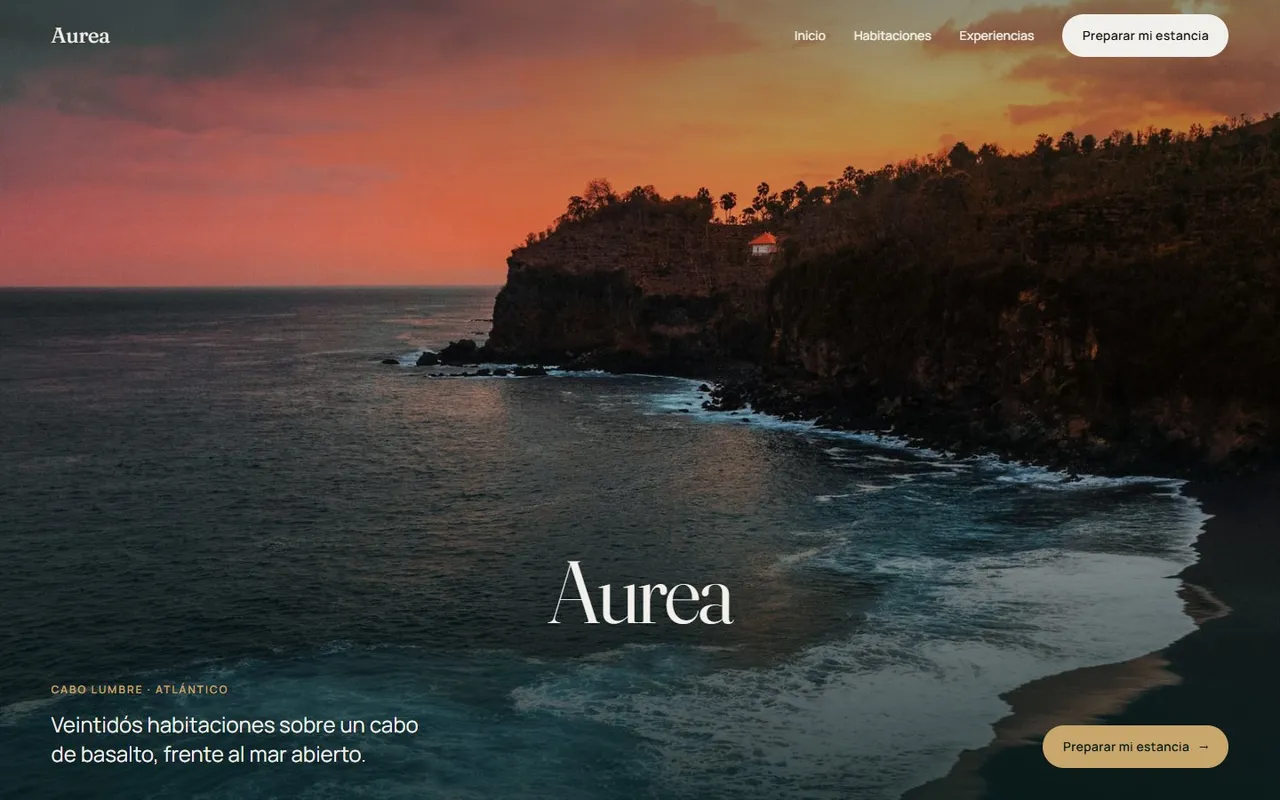
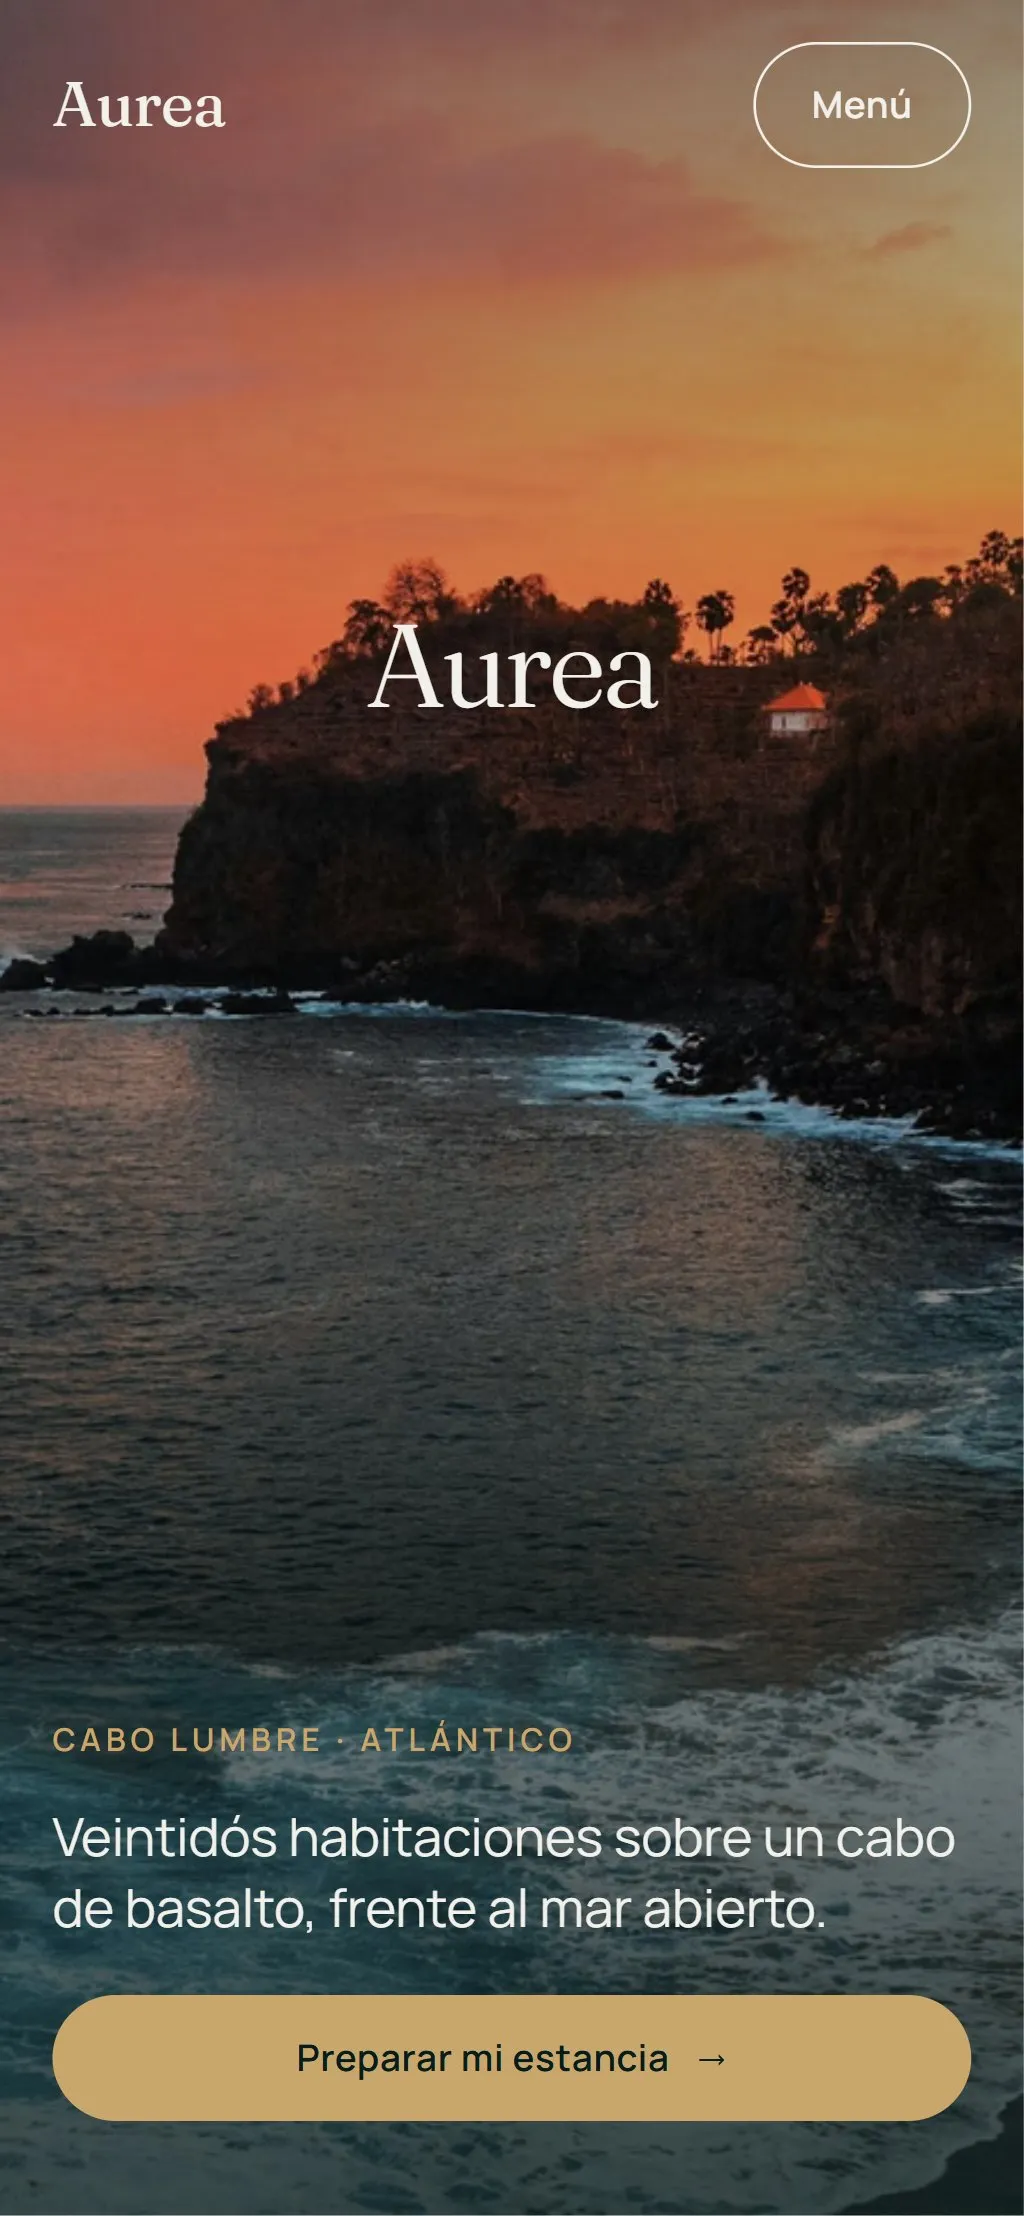
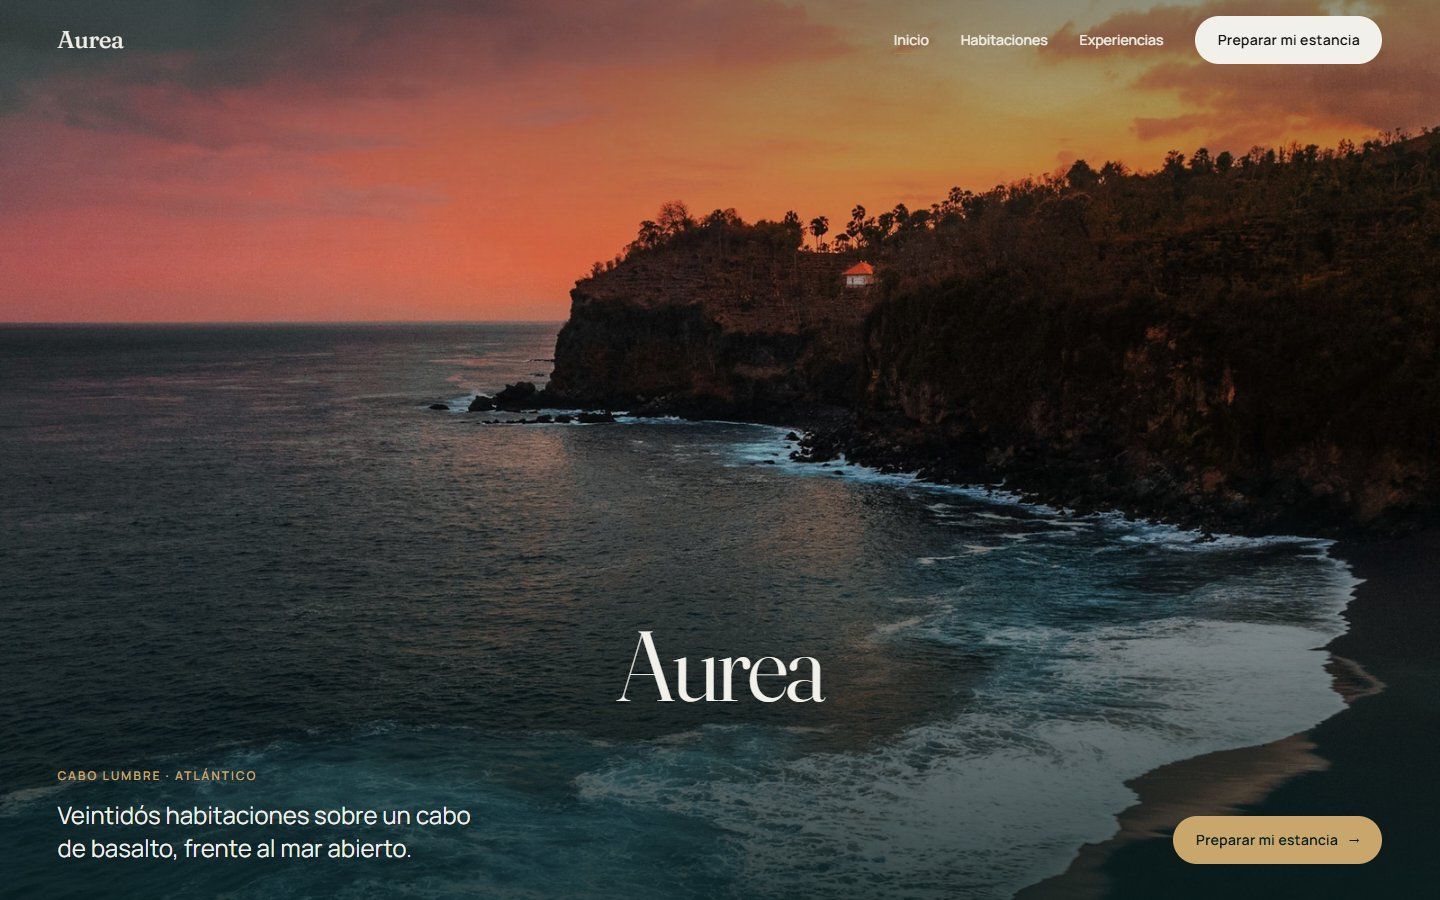
Portada de Aurea: un cabo de basalto sobre el mar al atardecer, con el nombre del hotel y la frase «Veintidós habitaciones sobre un cabo de basalto».

Professional

Aurea, hotel en Cabo Lumbre

Hotel boutique

Demo conceptual: un negocio ficticio

Objetivo

La web de un hotel boutique ficticio frente al Atlántico: diseño editorial en varias páginas, con animaciones ligadas al scroll, galerías por habitación y una reserva de demostración.

Qué muestra
  • Diseño editorial propio: tipografía Fraunces y Manrope, paleta marfil, noche y latón
  • Animaciones con GSAP ligadas al scroll, sin bloquear el desplazamiento
  • Explorador de habitaciones, galerías y visor a pantalla completa
  • Reserva de demostración en cinco pasos, con validación en cada uno
  • Modo de movimiento reducido, teclado y lector de pantalla; probado a 1440, 390 y 320 px
  • Imágenes AVIF y WebP por tamaño; el vídeo solo se carga al verlo
  • Signature

    Taller contemporáneo de platería, inspirado en Potosí

    Proyecto futuro Aún no está construida: no hay demo que abrir. Su vista previa y su enlace aparecerán aquí cuando se publique.

Python, datos y automatización

Proyectos personales, no trabajos para clientes: herramientas que importan, comprueban y mueven datos. Cada una se ejecuta en tu propio equipo y su código es público en GitHub.

QuoteFlow

Importa presupuestos desde CSV, Excel y PDF, con revisión humana

Útil si tu negocio recibe presupuestos, listas de precios o pedidos en archivos CSV, Excel o PDF, y alguien los pasa a mano a un sistema.

Proyecto personal con código público. Se ejecuta en tu propio equipo; no tiene demo pública. Su interfaz está en español.

El problema

Los presupuestos llegan en archivos CSV, Excel y PDF. Pasarlos a mano a un sistema es lento, y un valor erróneo o una fila repetida se cuelan con facilidad y cuestan de deshacer una vez guardados.

Lo que construí

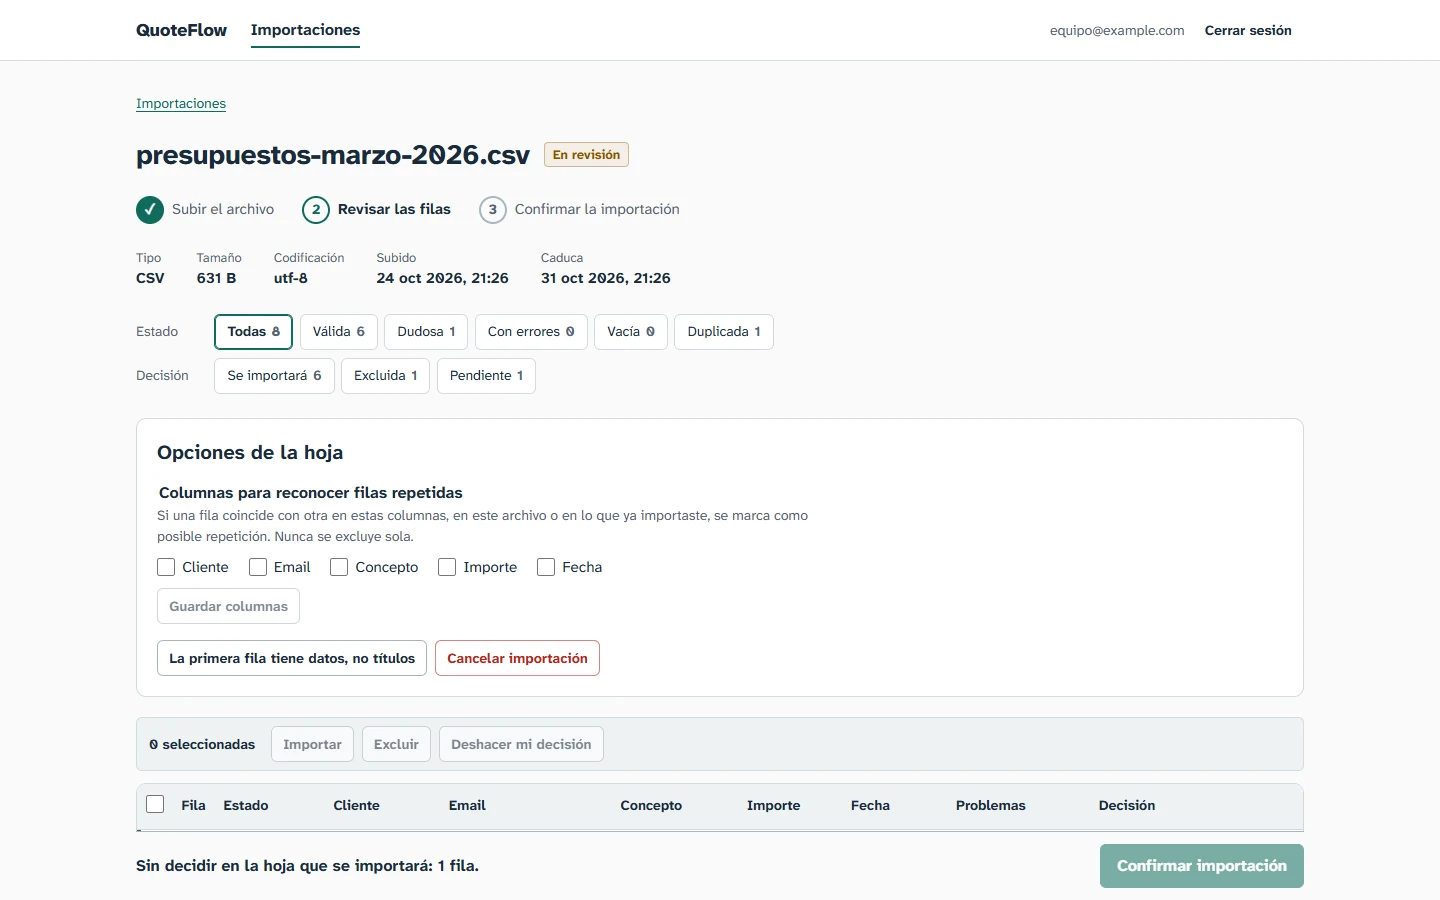
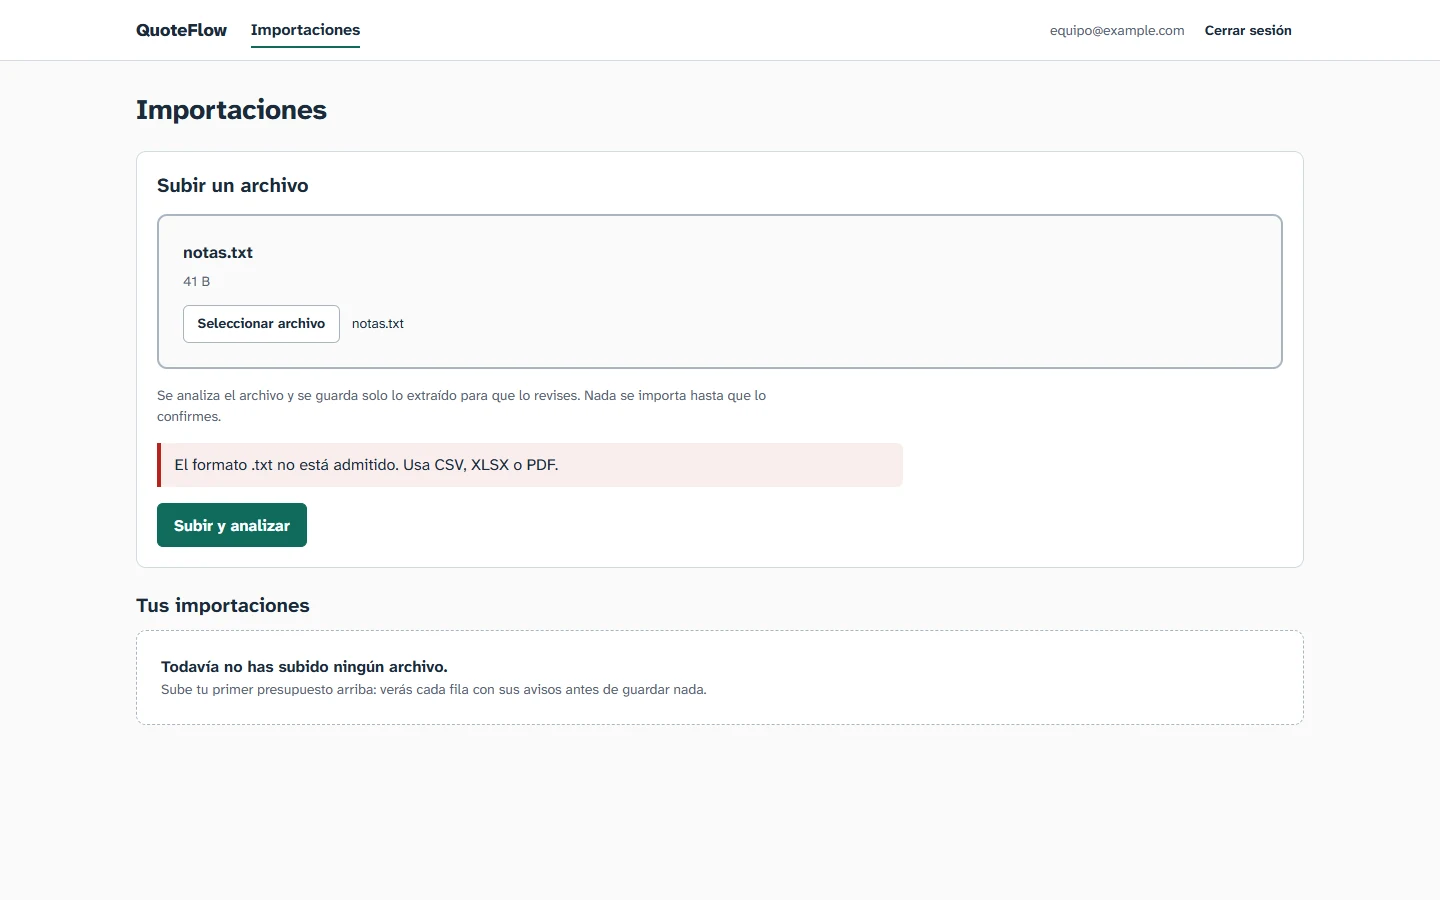
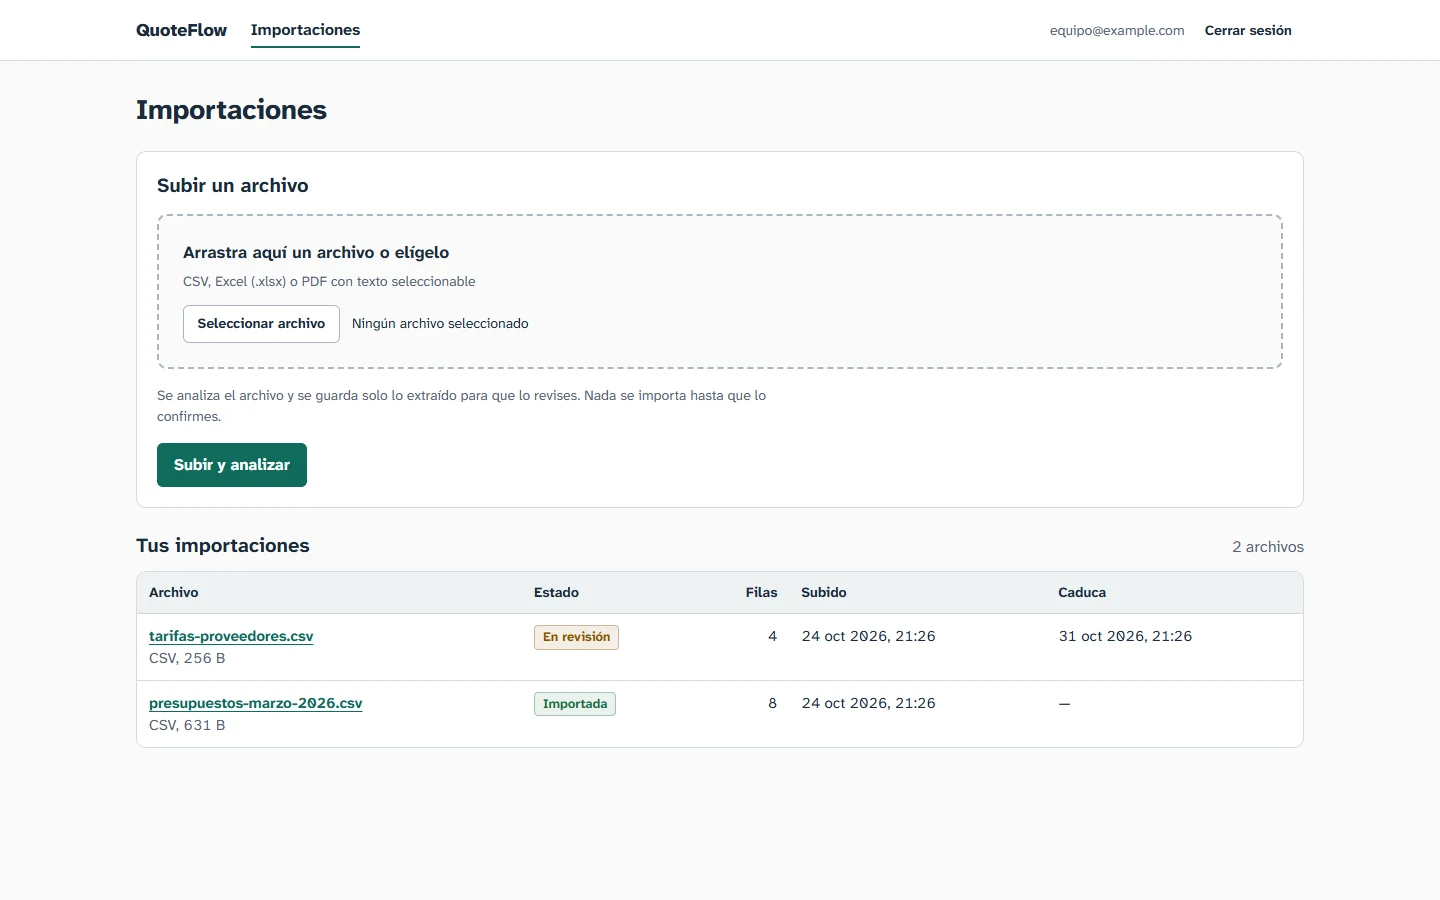
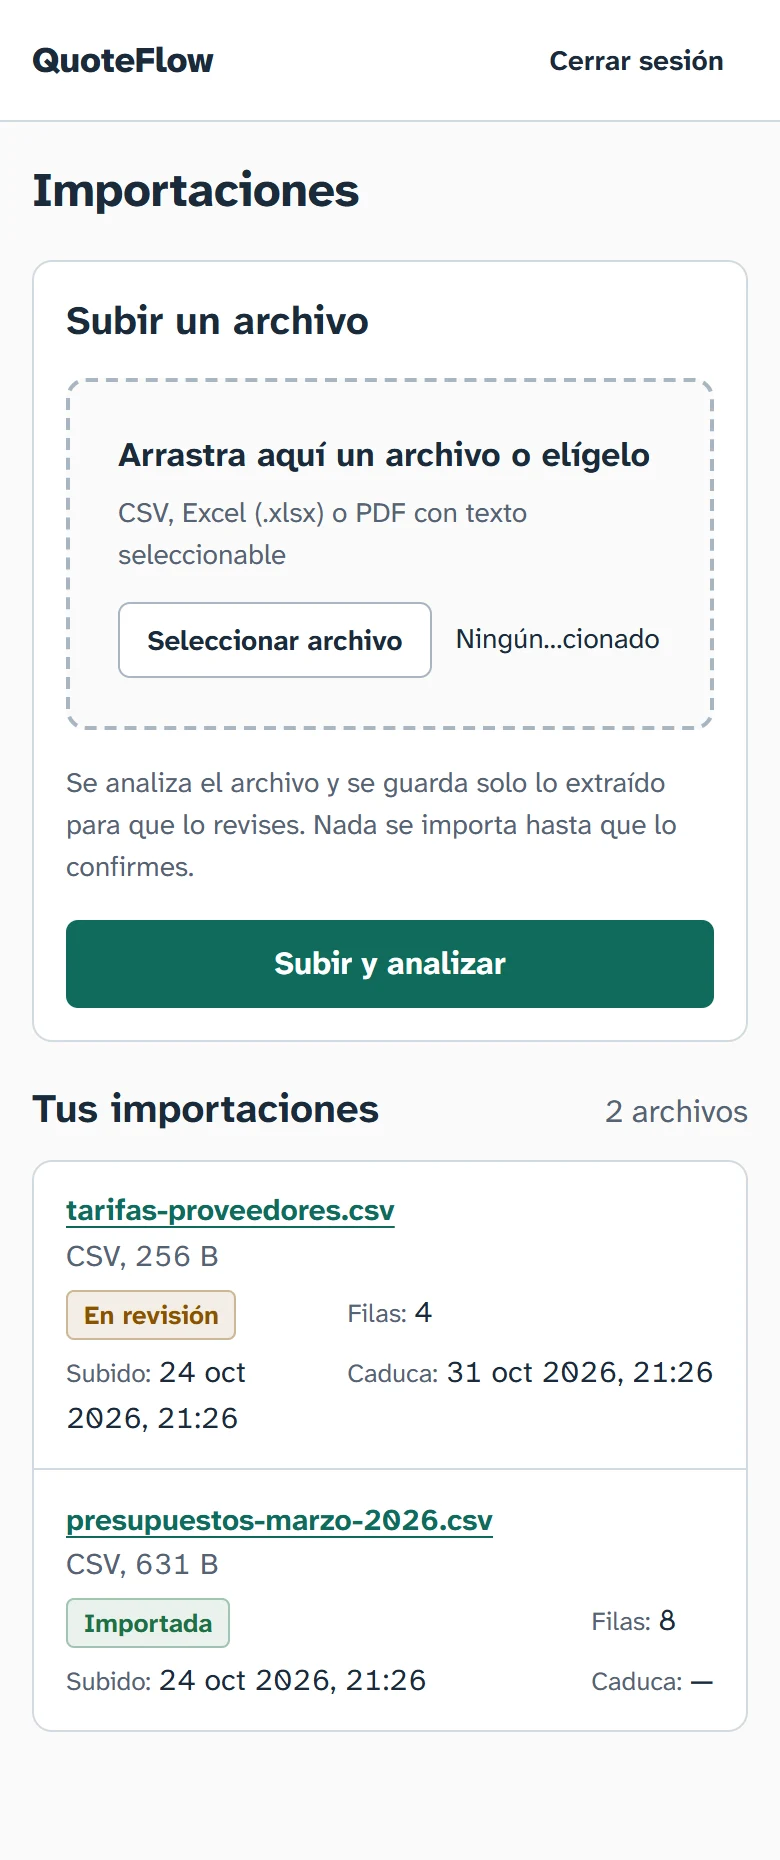
QuoteFlow importa presupuestos desde archivos CSV, XLSX y PDF. Cada archivo se analiza en un proceso aislado, se valida y se comprueba si tiene duplicados, y queda pendiente de revisión. Nada se guarda como registro hasta que una persona lo confirma.

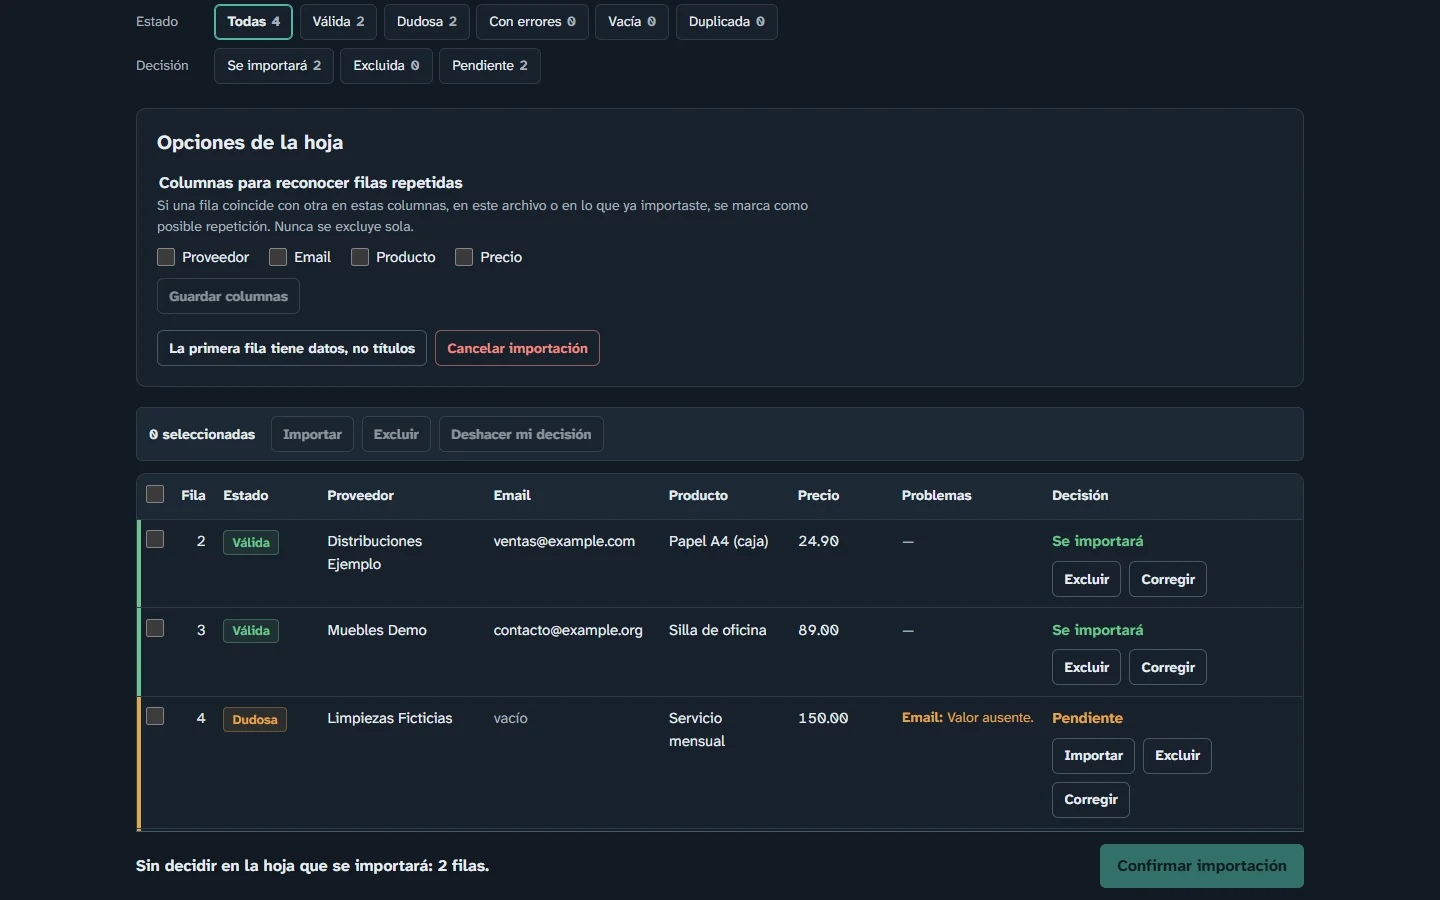
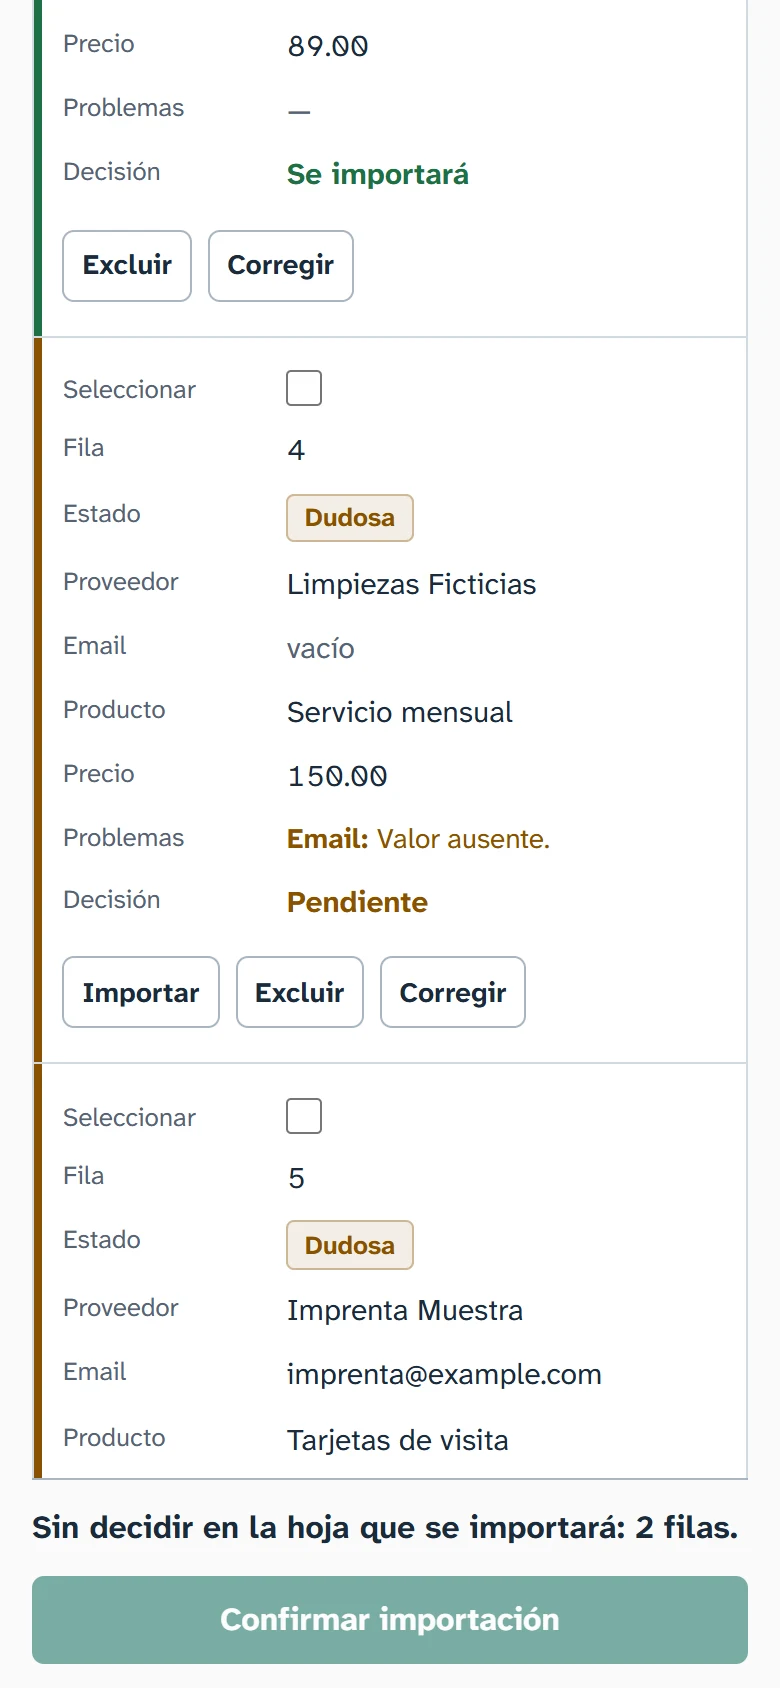
Pantalla de revisión de QuoteFlow con pasos, filtros y opciones de la hoja
Revisión: pasos, filtros de filas por estado y decisión, y opciones de la hoja.
Qué puedes hacer con él
  • Subir un archivo CSV, Excel o PDF y ver cada fila comprobada antes de guardar nada
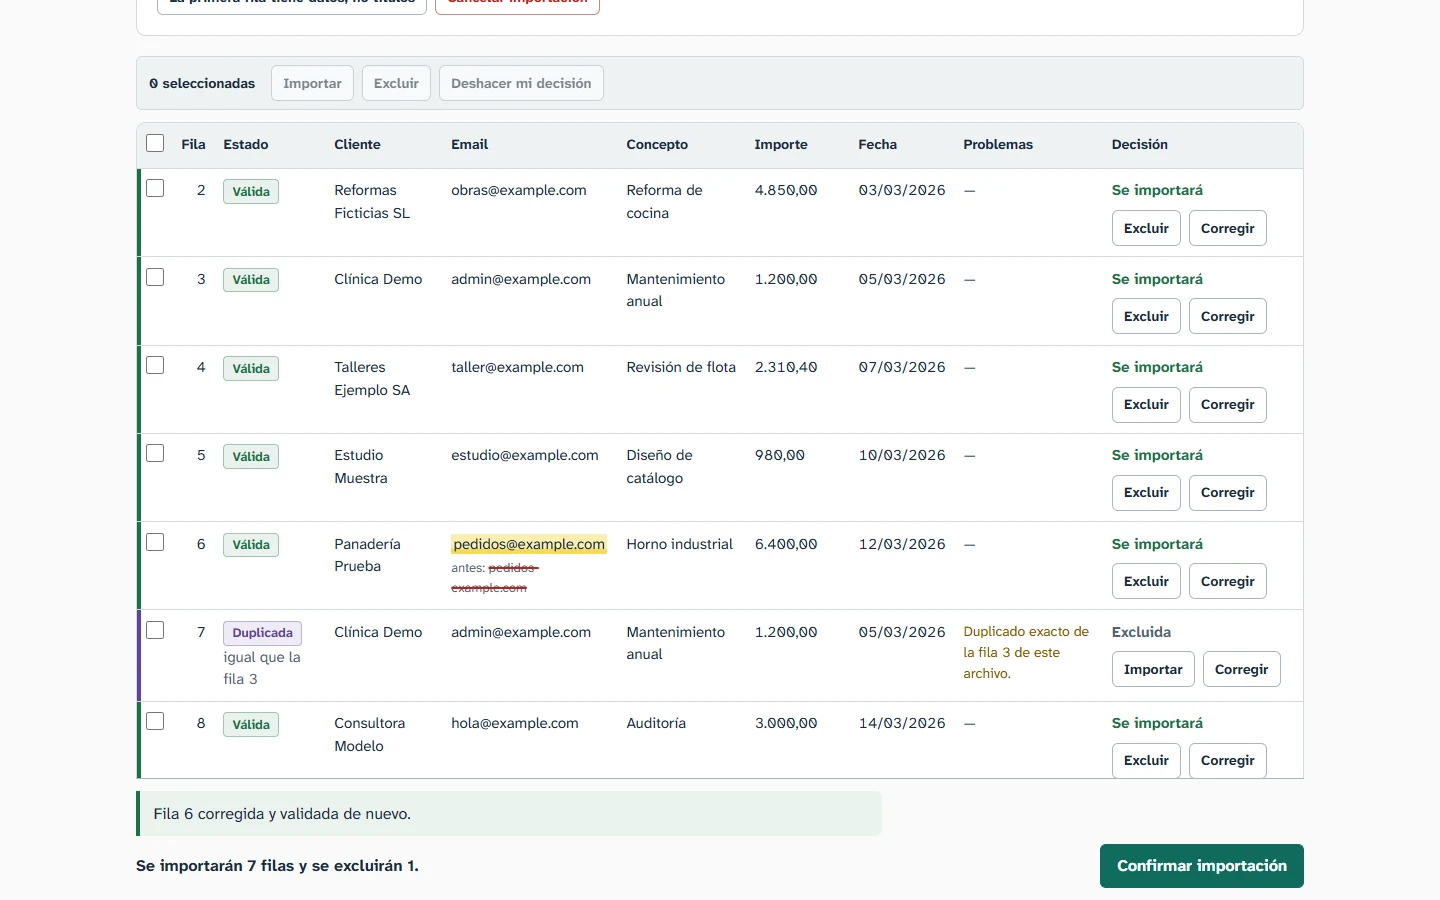
  • Filtrar las filas por estado y decisión, y aceptarlas, excluirlas o corregirlas una a una o en bloque
  • Ver cada valor corregido resaltado, con el valor original tachado
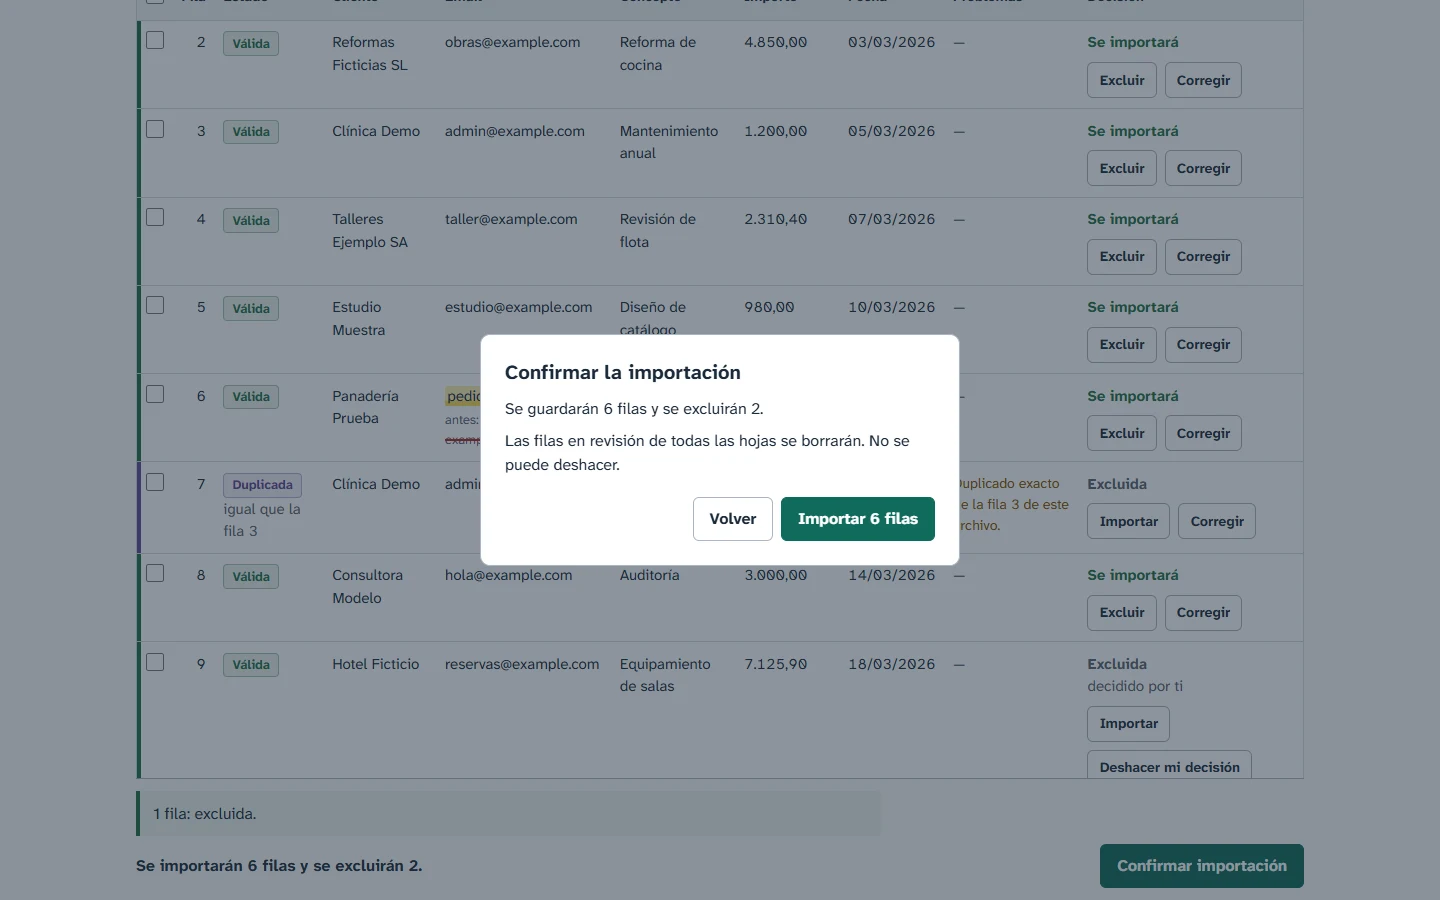
  • Confirmar la importación tras un resumen de cuántas filas se guardarán y cuántas se excluirán
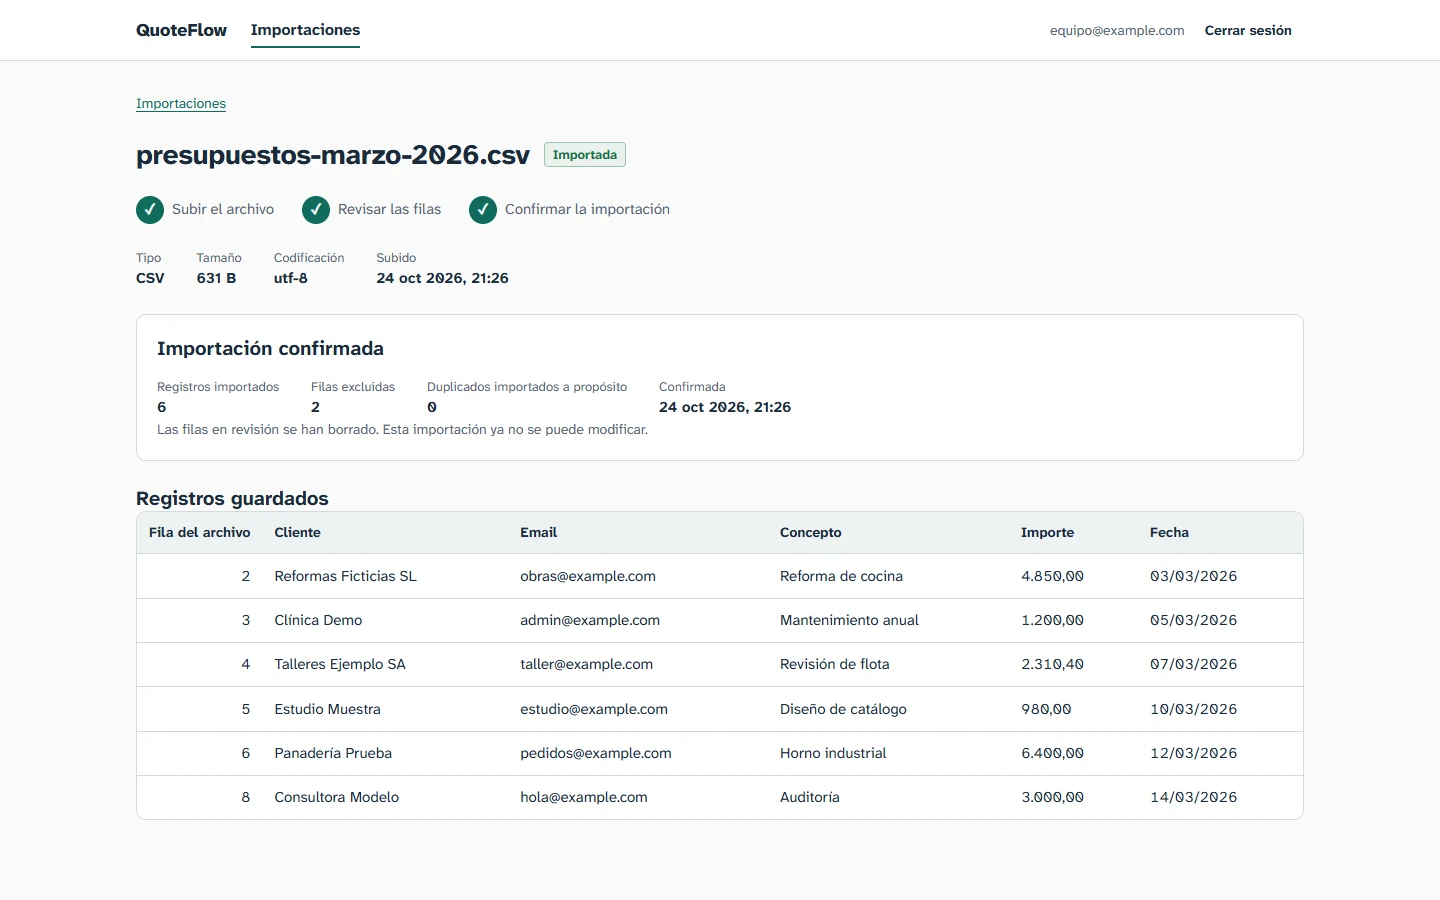
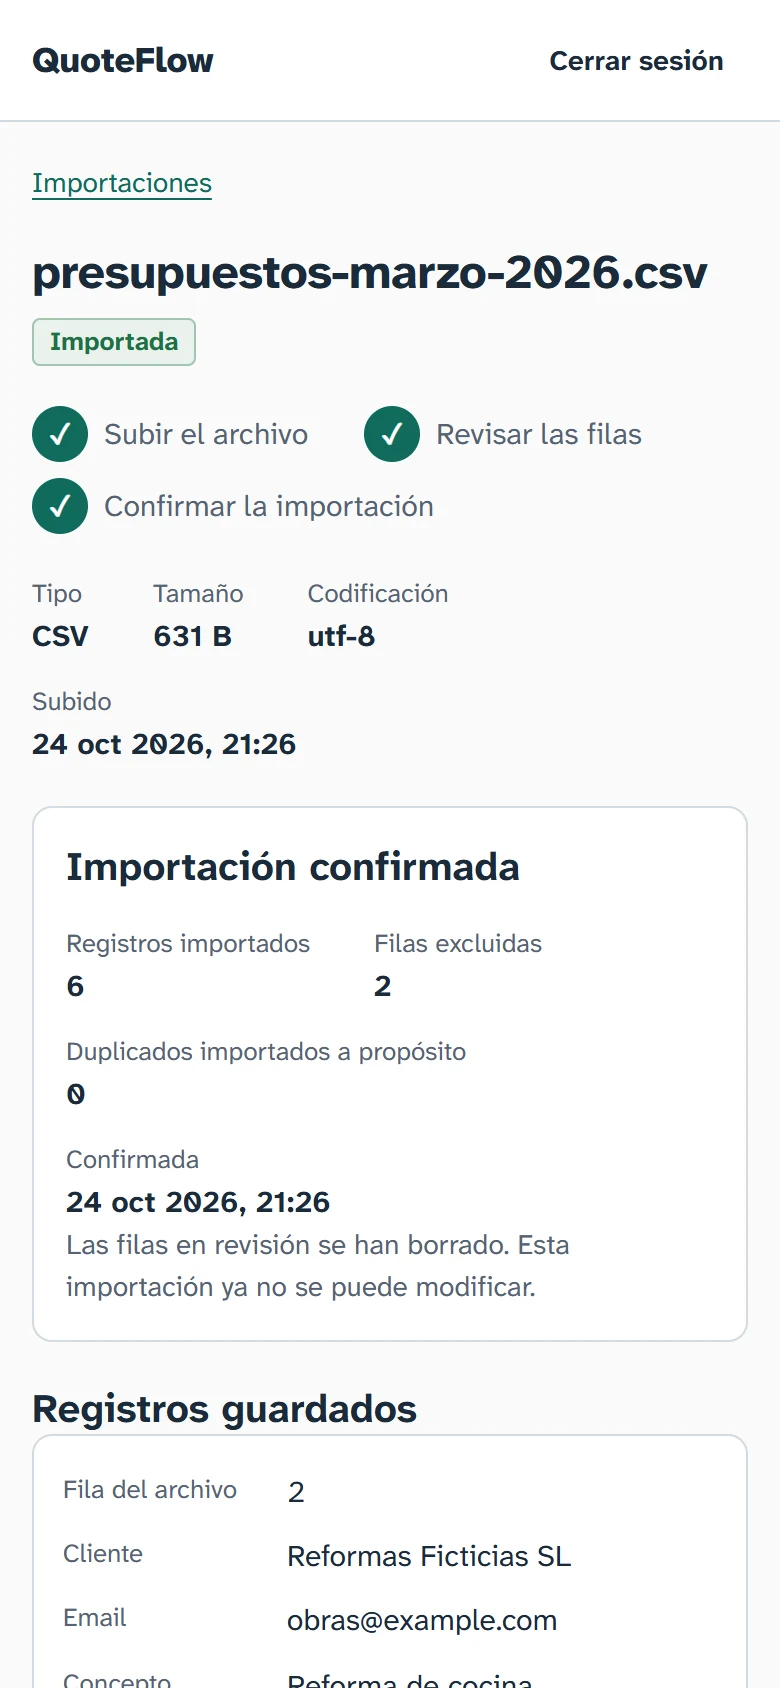
  • Consultar los registros que guardó cada importación confirmada
Código en GitHub (se abre en una pestaña nueva)
Detalles técnicosFunciones, decisiones, pruebas y limitaciones
Demo
Sin demo pública: se ejecuta en local.
Licencia
MIT
Hecho con

Python, FastAPI, SQLAlchemy 2, Alembic, psycopg 3, Argon2, PyJWT, openpyxl, pypdf, PostgreSQL 18, Next.js 16, React 19, TypeScript, Docker Compose, pytest, node:test, Ruff, ESLint

Funciones
  • Flujo de importaciónSubida, análisis aislado con límites de tamaño, filas y tiempo, validación y detección de duplicados frente a los registros del propio usuario.
  • Revisión humanaFiltrar filas por estado y decisión, aceptarlas o excluirlas una a una o en bloque, y corregir celdas. La celda corregida queda resaltada, con el valor original tachado.
  • Confirmación explícitaUn diálogo indica cuántas filas se guardarán y cuántas se excluirán antes de guardar nada.
  • Registros guardadosCada importación confirmada muestra los registros que guardó, paginados y de solo lectura.
  • SesionesSesiones con cookie, protección CSRF, contraseñas con Argon2 y límite de intentos de inicio de sesión. La página avisa antes de que caduque una sesión inactiva, y las correcciones sin guardar se recuperan al volver a entrar.
  • Registro de auditoríaSe registran las importaciones y los inicios de sesión, con los correos seudonimizados.
  • Integración con n8n (opcional)Un endpoint que recibe archivos con token bearer e Idempotency-Key. Probado a mano contra la base de pruebas: la primera llamada devolvió 201 y la repetición con la misma clave, 200 con el mismo lote. Desactivada salvo que se configure.
Decisiones técnicas
  • Nada se guarda sin aprobación.

    Las filas esperan en una tabla temporal. Al confirmar, se guardan las filas aceptadas de la hoja elegida y se borran todas las filas temporales del lote en una sola transacción; ante cualquier error, se deshace todo.

  • Los duplicados son privados.

    Las filas solo se comparan con registros confirmados por el mismo usuario. Los registros de otros usuarios nunca se comparan ni se revelan.

  • Una fila inválida no se puede aceptar.

    Si una petición intenta aceptar una fila inválida o vacía, se rechaza entera con un 422.

  • Los archivos subidos no tocan el disco.

    El archivo se lee en memoria con un límite de tamaño y se calcula su SHA-256; no se escribe en disco ni se guarda en la base de datos.

  • El modo producción rechaza configuraciones inseguras.

    Con QF_ENV=production, la API no arranca sin cookies seguras, orígenes HTTPS y secretos nuevos.

Cómo ejecutarlo

Requisitos: Docker con Compose, Python 3.12 o posterior (desarrollado y probado con CPython 3.14), Node.js 24 y npm.

Una instalación nueva en PowerShell de Windows, tal como la da el README del proyecto. El README también cubre una base de datos existente, macOS y Linux.

  1. Configuración: copia el ejemplo y sustituye cada valor “change-me”

    Copy-Item .env.example .env
  2. Comprueba que aún no existe ninguna base de datos: este comando debe fallar con “no such volume”

    docker volume inspect quoteflow_pgdata
  3. Arranca PostgreSQL, con la base principal y la de pruebas

    docker compose up -d
  4. Backend: entorno virtual y las versiones exactas con las que pasaron las pruebas

    cd backend
    py -3.14 -m venv .venv
    .\.venv\Scripts\python -m pip install -e ".[dev]" -c constraints.txt
  5. Bases de datos: primero la de pruebas y luego la principal (“alembic current” no debe mostrar ninguna revisión)

    .\.venv\Scripts\alembic -x db=test upgrade head
    .\.venv\Scripts\alembic current
    .\.venv\Scripts\alembic upgrade head
  6. Usuario administrador de desarrollo y luego la API en el puerto 8000

    .\.venv\Scripts\python -m app.cli create-admin
    .\.venv\Scripts\uvicorn app.main:create_app --factory --host 127.0.0.1 --port 8000
  7. Frontend, en una segunda terminal; después abre http://localhost:3000

    cd frontend
    npm ci
    npm run dev
Pruebas que puedes ejecutar

512

pruebas de backend

pytest, contra una base de datos de pruebas separada que se vacía entre pruebas

46

pruebas de frontend

node:test, contra el build de producción con una API simulada

También se comprueba con Ruff (lint y formato), ESLint y el compilador de TypeScript.

cd backend
.\.venv\Scripts\python -m pytest
.\.venv\Scripts\ruff check .
.\.venv\Scripts\ruff format --check .

cd ..\frontend
npm run lint
npm run build
npx tsc --noEmit
npm test
Limitaciones conocidas
  • La interfaz está solo en español y las horas se muestran siempre en la zona America/La_Paz.
  • Los registros guardados se consultan por importación; todavía no hay búsqueda entre importaciones.
  • Las revisiones caducadas se purgan con un comando que hay que programar aparte.
  • No está listo para producción: faltan el despliegue con HTTPS, la rotación de secretos, límites de subidas simultáneas y un límite de memoria del sistema para el análisis.

LeadFlow

Formulario de captación de leads y un CRM sencillo

Útil si las consultas te llegan desde un formulario de tu web y necesitas dar seguimiento a cada una, sin duplicados y sin perder el hilo.

Proyecto personal con código público. Se ejecuta en tu propio equipo y no tiene cuentas de usuario, así que está pensado para uso local.

El problema

Las consultas que llegan desde el formulario de una web suelen acabar en el correo o en una hoja de cálculo. La misma persona puede quedar guardada dos veces, y cuesta saber a quién se contactó, qué se habló y qué sigue.

Lo que construí

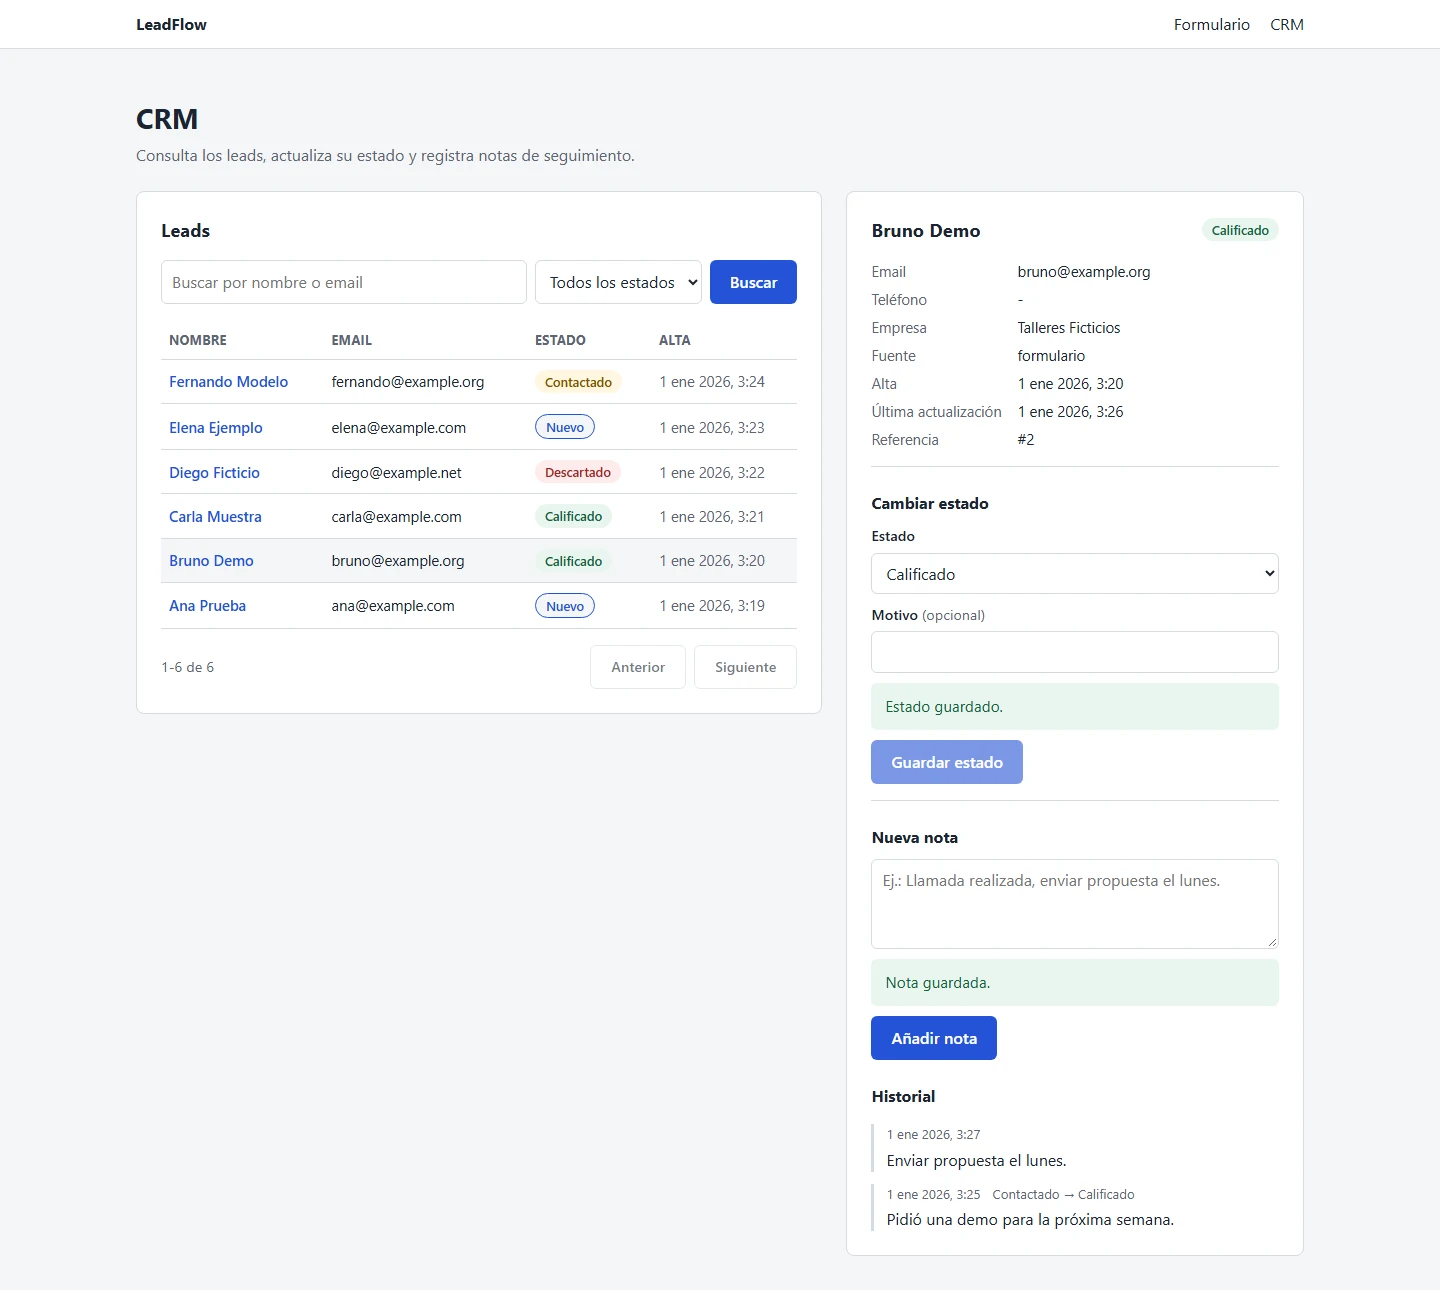
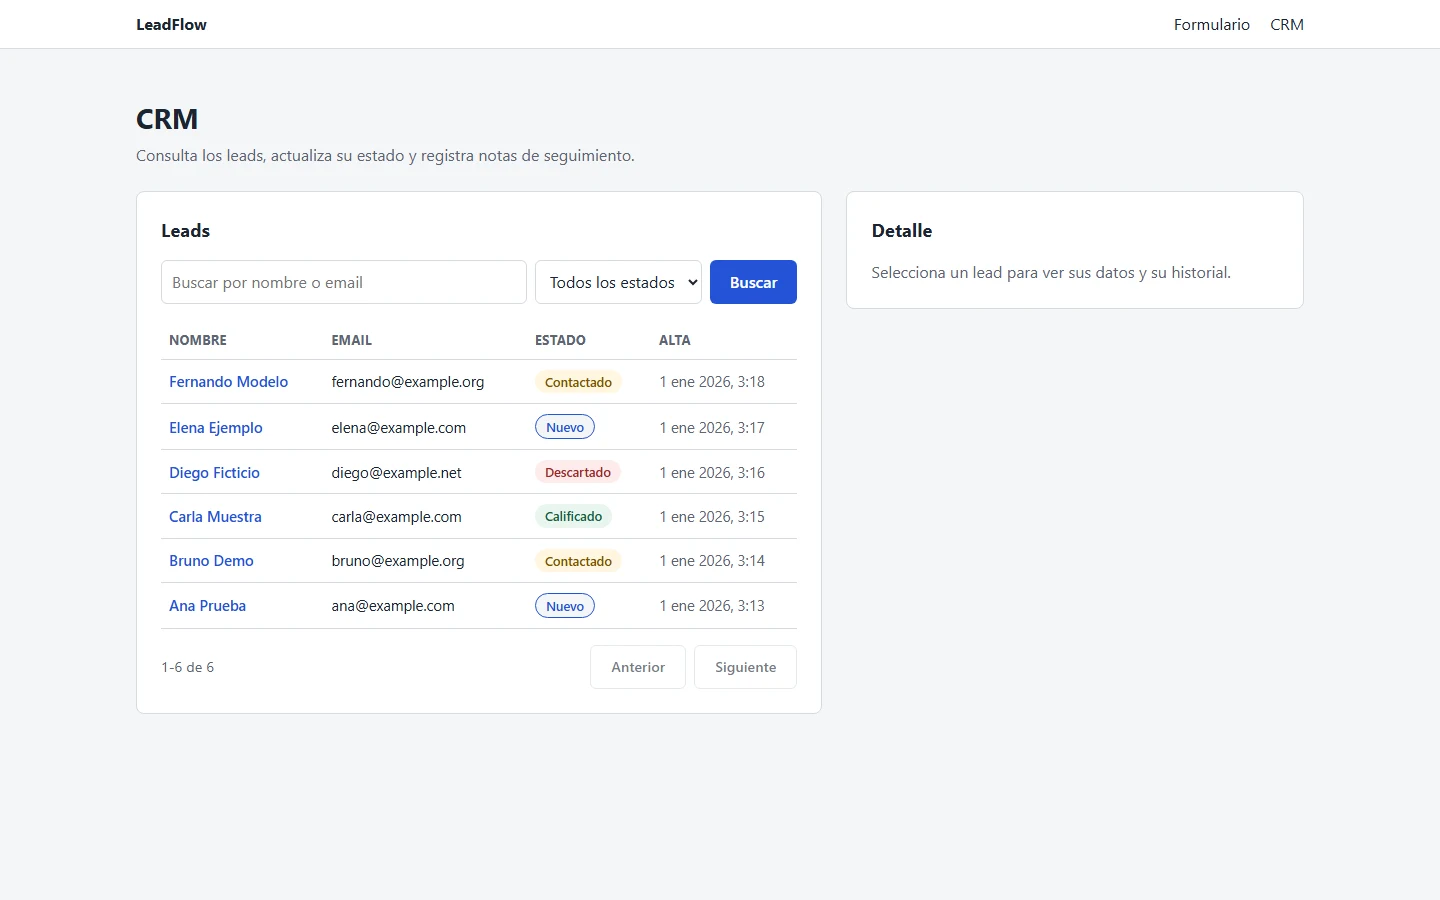
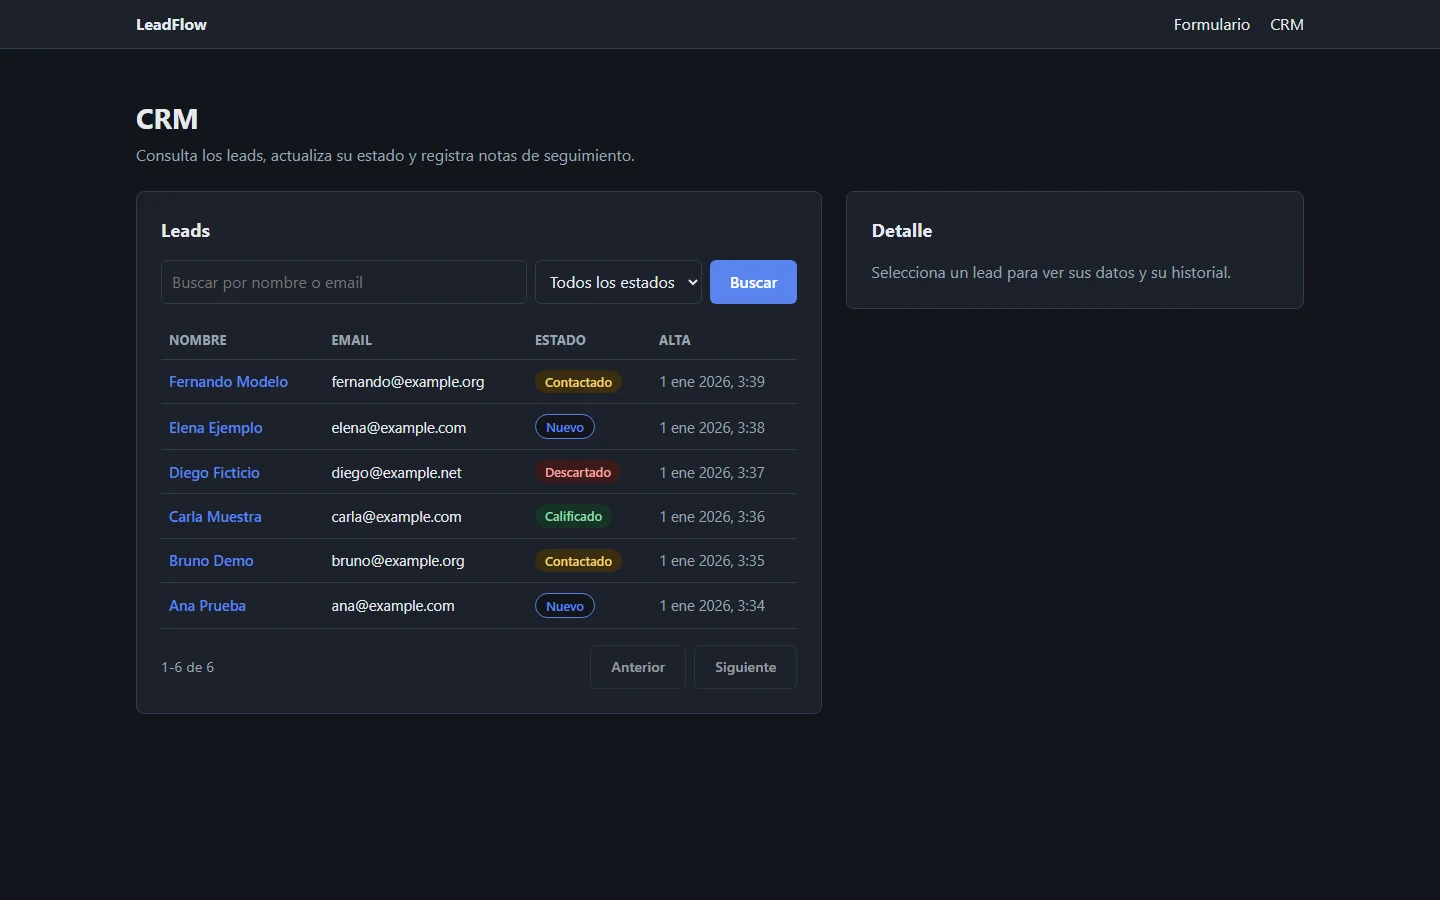
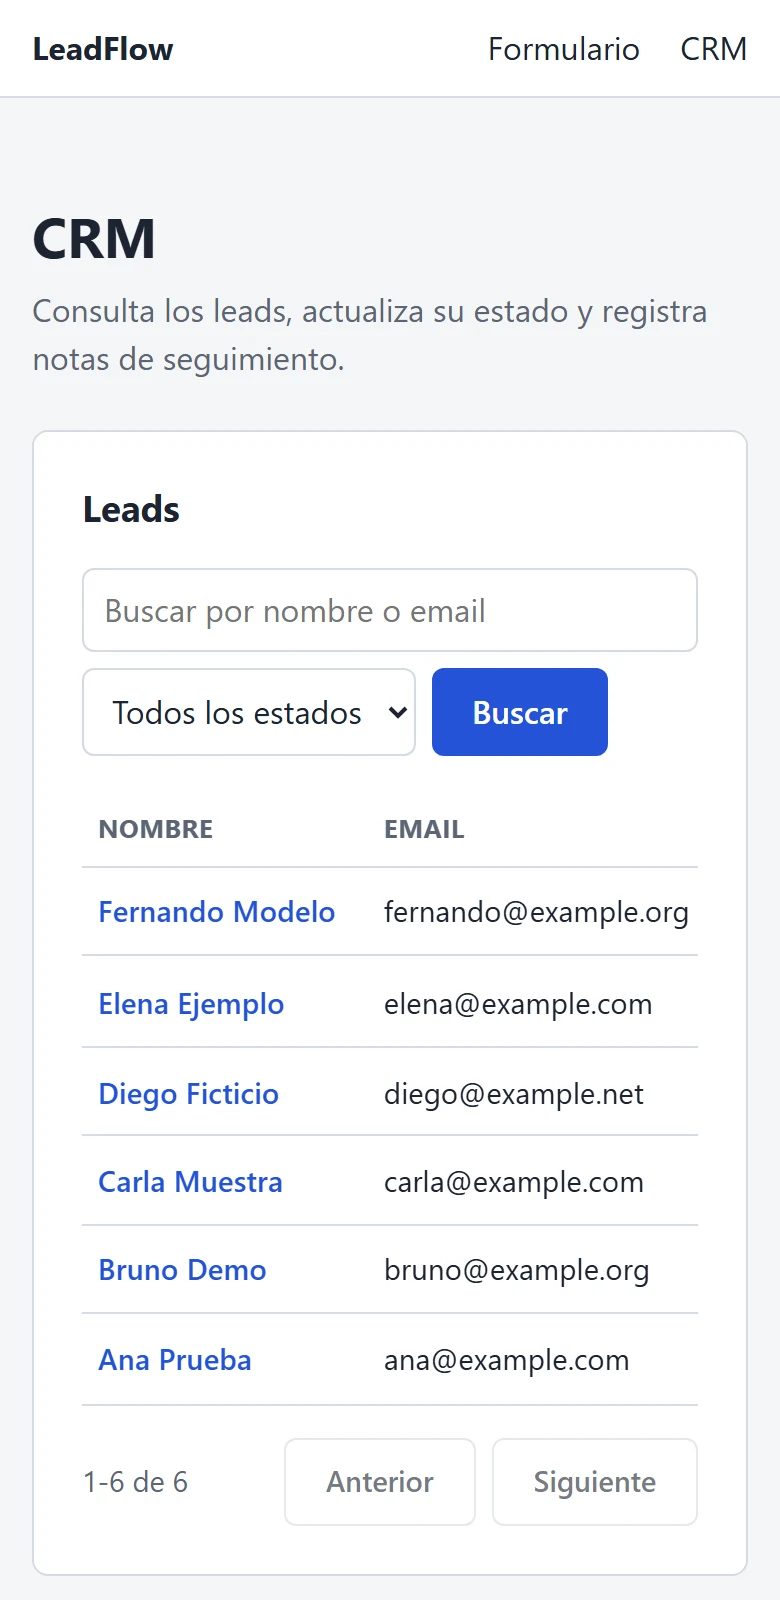
LeadFlow capta leads desde un formulario web, los guarda en PostgreSQL sin duplicados y sigue el estado, las notas y el historial de cada lead en un panel CRM sencillo.

CRM de LeadFlow con los datos y el historial de un lead
Panel CRM: datos de un lead, cambio de estado e historial de notas.
Qué puedes hacer con él
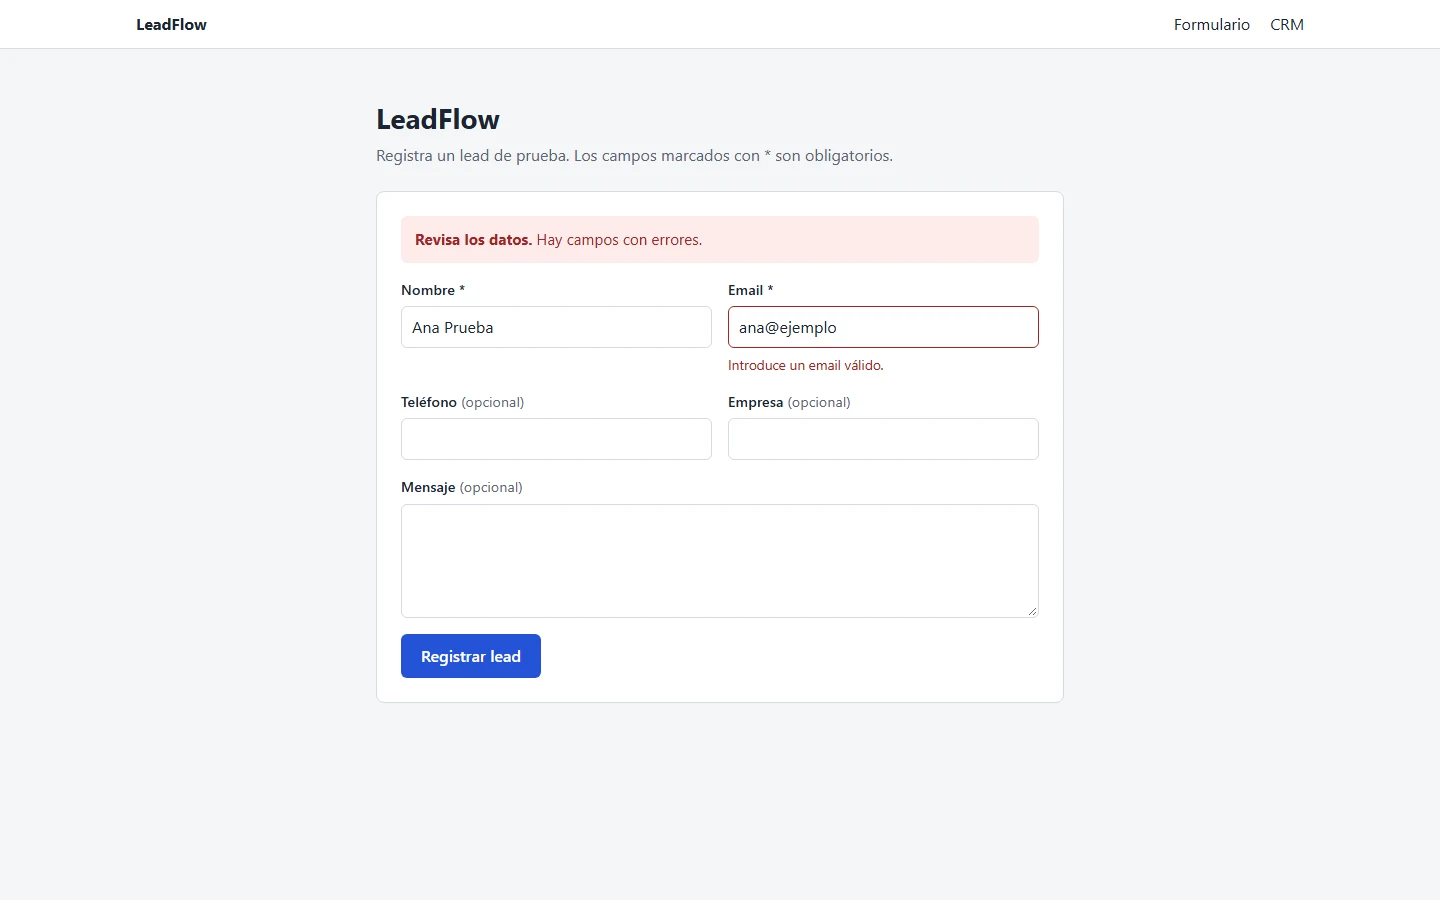
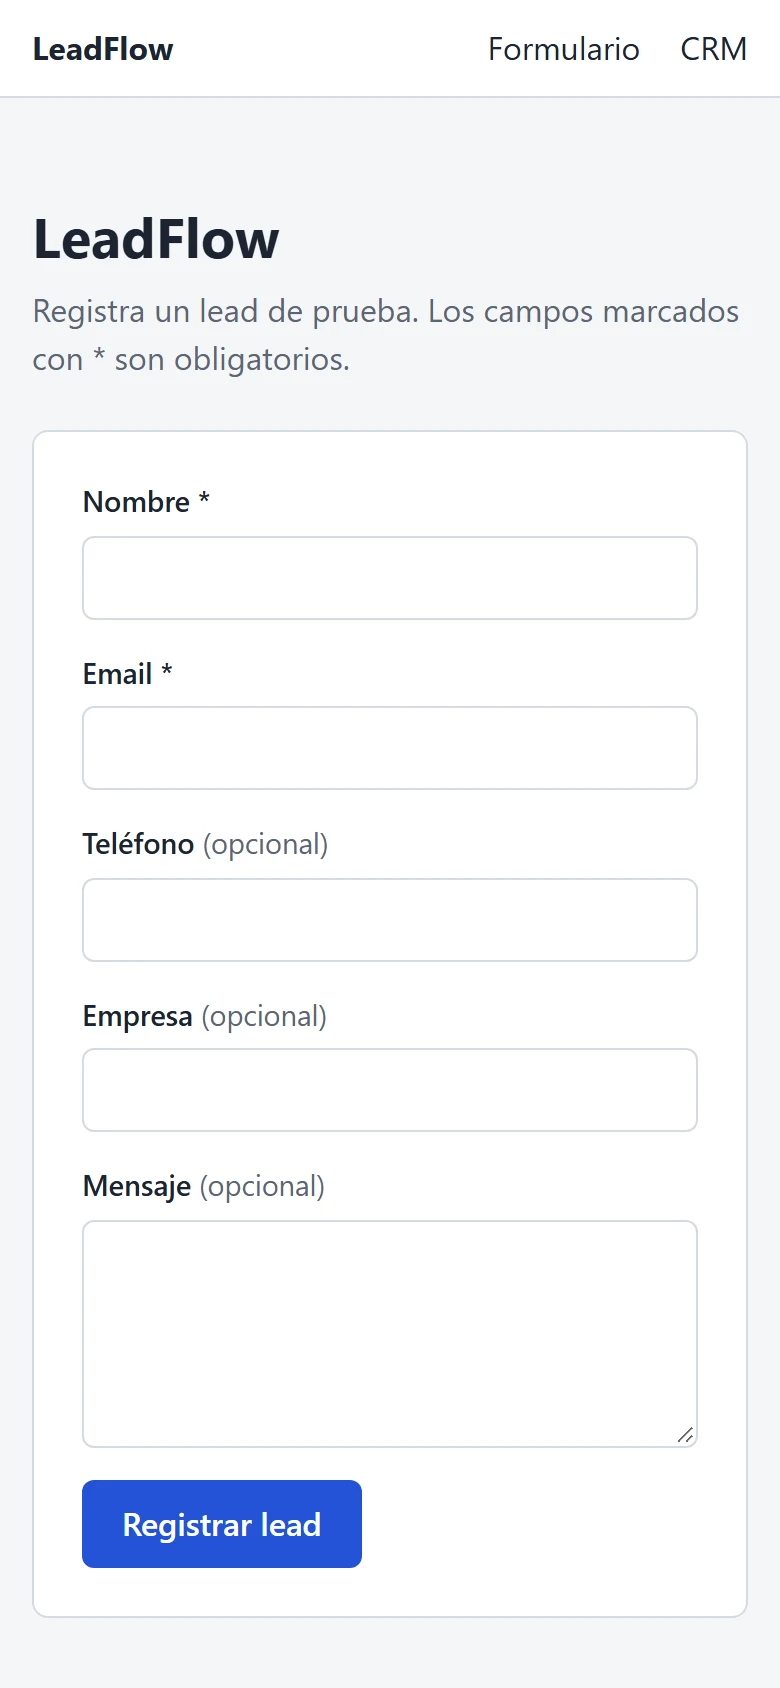
  • Enviar un lead desde un formulario que señala cada error junto a su campo
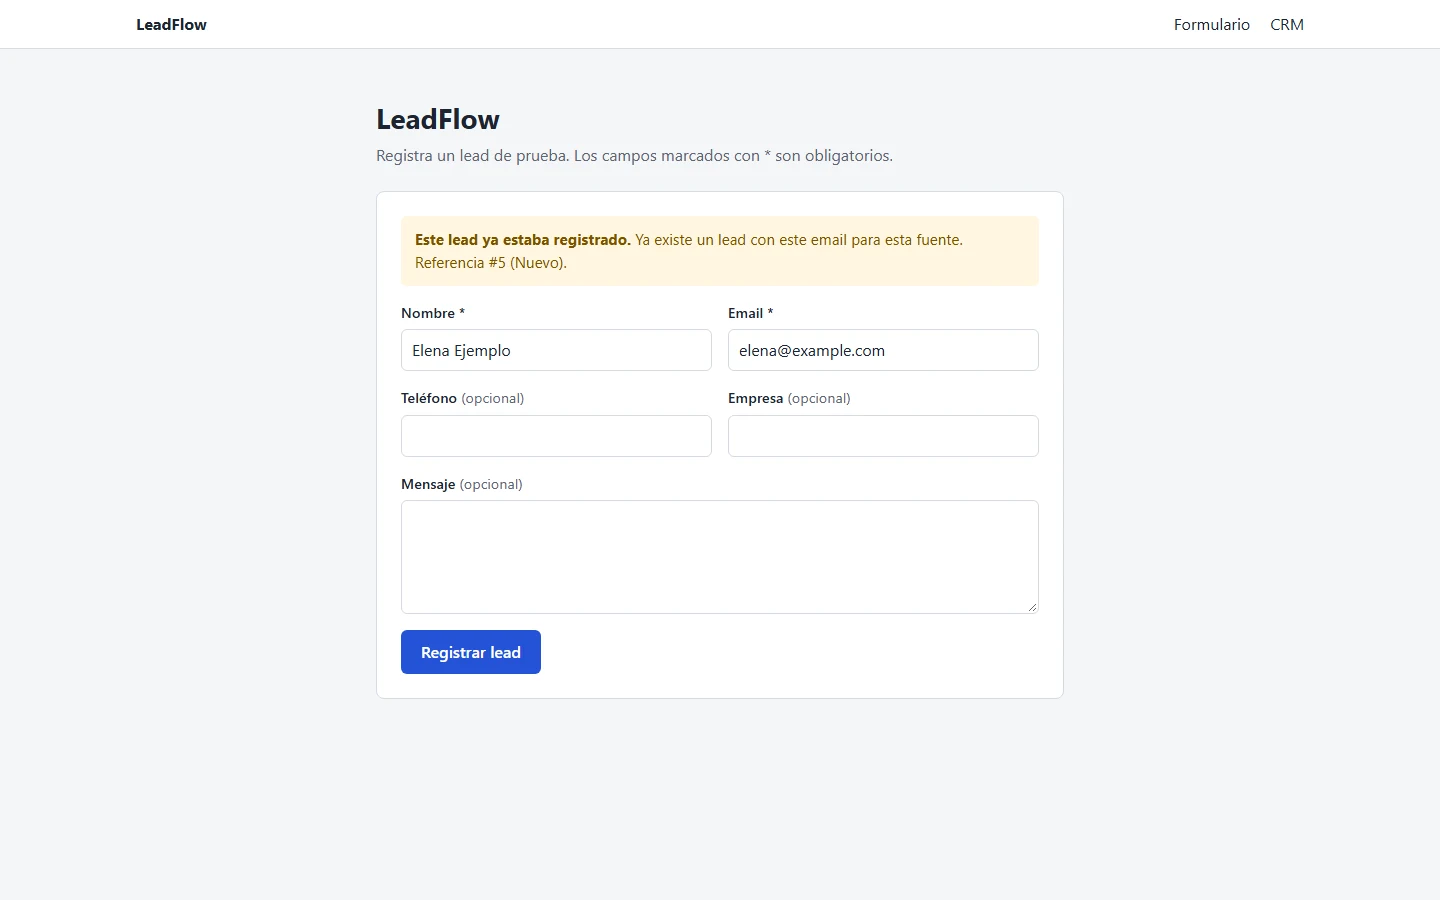
  • Enviar el mismo lead dos veces y recibir el registro existente en lugar de un duplicado
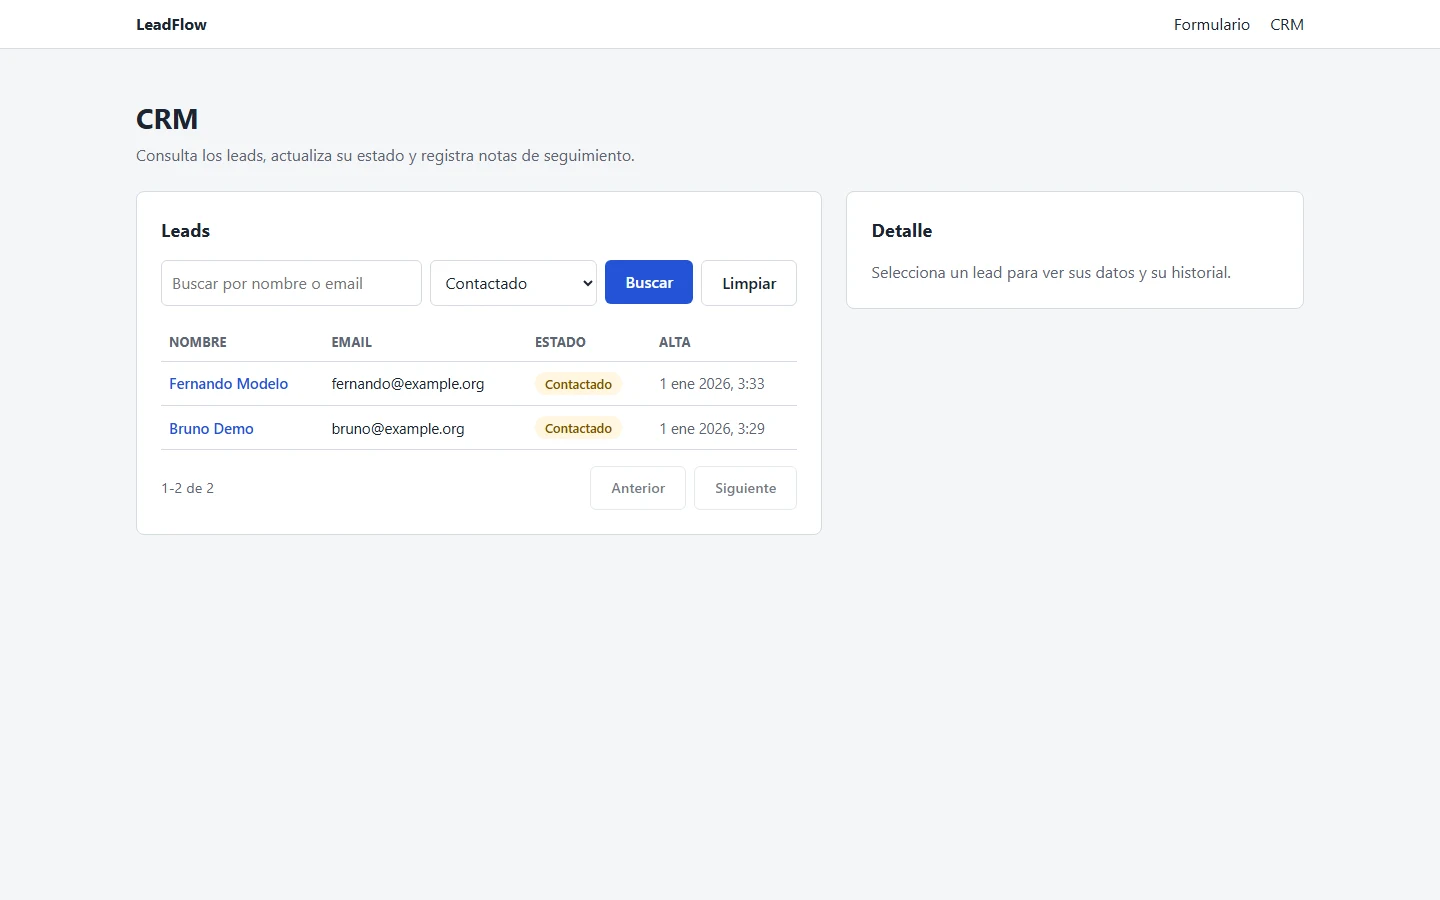
  • Buscar los leads por nombre o email y filtrarlos por estado
  • Cambiar el estado de un lead con un motivo opcional
  • Añadir notas de seguimiento y leer el historial de cada lead
Código en GitHub (se abre en una pestaña nueva)

El flujo completo en 13 segundos

Registrar un lead, abrirlo en el CRM, cambiar su estado y añadir una nota. Datos ficticios, con la API simulada en el navegador.

Detalles técnicosFunciones, decisiones, pruebas y limitaciones
Demo
Sin demo pública: se ejecuta en local.
Hecho con

Python, FastAPI, Pydantic 2, SQLAlchemy 2, psycopg 3, PostgreSQL 18, Next.js 16, React 19, TypeScript, Docker Compose, pytest, Playwright, Ruff

Funciones
  • Formulario validadoSe comprueba en el navegador y en el servidor; los errores del servidor aparecen junto al campo correspondiente.
  • Altas idempotentesCada envío lleva un event_id, así que un envío repetido nunca crea una segunda fila.
  • Sin leads duplicadosEl mismo correo desde la misma fuente se reconoce como un lead existente. Las dos reglas se aplican con restricciones UNIQUE en PostgreSQL.
  • Panel CRMListado paginado con búsqueda por nombre o correo, filtro por estado, cambio de estado con motivo opcional, notas de seguimiento e historial.
  • Registro de errores limpioLos errores se guardan después de eliminar contraseñas, tokens, correos y teléfonos.
Decisiones técnicas
  • El navegador nunca llama directamente a la API.

    Las rutas de servidor de Next.js reenvían cada petición a FastAPI con un tiempo máximo y devuelven mensajes genéricos, para no exponer detalles internos.

  • El proxy solo acepta JSON.

    Otros tipos de contenido reciben un 415 y los cuerpos de más de 64 KB, un 413, de modo que otra web abierta en el navegador no puede enviarle formularios.

  • Los logs solo llevan identificadores.

    event_id y lead_id; nunca nombres, correos ni el texto de las notas.

Cómo ejecutarlo

Requisitos: Node.js 20 o posterior (probado con 24), Python 3.11 o posterior (probado con 3.14) y PostgreSQL 18, con Docker Desktop o una instalación local.

PowerShell de Windows, tal como lo da el README del proyecto.

  1. Configuración: los dos archivos están ignorados por Git; los valores de ejemplo funcionan tal cual con Docker

    Copy-Item .env.example .env
    Copy-Item frontend/.env.example frontend/.env.local
  2. Base de datos: espera a que aparezca “healthy”

    docker compose up -d postgres
    docker compose ps
  3. Backend, terminal 1; la documentación de la API está en http://localhost:8000/docs

    cd backend
    py -3.14 -m venv .venv
    .\.venv\Scripts\Activate.ps1
    pip install -r requirements.txt
    python -m app.init_db
    uvicorn app.main:app --reload
  4. Frontend, terminal 2: el formulario en http://localhost:3000 y el CRM en /crm

    cd frontend
    npm install
    npm run dev
Pruebas que puedes ejecutar

148

pruebas de backend

pytest, contra una base de datos de pruebas separada

17

pruebas de extremo a extremo

Playwright en Chromium, con la API simulada en el navegador

Código comprobado con Ruff.

cd backend
pytest
ruff check .

cd frontend
npx playwright install chromium
npm run test:e2e
Limitaciones conocidas
  • Sin autenticación: quien tenga acceso puede ver y modificar todos los leads, por eso está pensado solo para uso local.
  • Sin migraciones: las tablas se crean si faltan, pero los cambios en tablas existentes no se aplican.
  • Sin despliegue, sin Dockerfiles para las aplicaciones y sin integración continua.

Book Data Extractor Pro

Scraper web en Python con exportación a Excel y CSV

Útil si necesitas los datos de un catálogo público en línea en una hoja de cálculo, sin copiarlos página por página.

Proyecto personal con código público. Se ejecuta en tu propio equipo; sus pruebas se ejecutan en GitHub Actions.

El problema

Copiar los datos de los productos de un catálogo en línea, página tras página, a una hoja de cálculo es lento y deja precios incoherentes, campos vacíos y filas repetidas.

Lo que construí

Extrae título, precio, moneda, disponibilidad y URL de un catálogo de libros paginado con Playwright, limpia los datos, elimina duplicados y exporta archivos Excel y CSV. Pensado para sitios de práctica de scraping como books.toscrape.com.

Cómo se ejecuta
python main.py --limit 50
python main.py --profile my_site.json --limit 20
Qué puedes hacer con él
  • Ejecutar un comando y obtener el título, precio, moneda, disponibilidad y enlace de cada producto
  • Abrir el resultado como un Excel con formato o un CSV compatible con Excel
  • Ver los campos que faltan marcados en lugar de descartados en silencio
  • Apuntarlo a otro catálogo escribiendo un perfil de sitio pequeño, sin cambiar el código
Código en GitHub (se abre en una pestaña nueva)
Detalles técnicosFunciones, decisiones, pruebas y limitaciones
Hecho con

Python, Playwright, openpyxl, pytest, GitHub Actions

Funciones
  • Los selectores están en perfiles JSON por sitio, separados del motor
  • Precios leídos con Decimal; los campos que faltan se marcan en vez de borrarse
  • Duplicados eliminados por URL normalizada
  • Excel con formato y CSV compatible con Excel, con protección contra inyección de fórmulas
  • Pruebas unitarias offline con pytest en GitHub Actions
Cómo ejecutarlo

Requisitos: Python 3.11, 3.12 o 3.13, y conexión a internet.

PowerShell de Windows, tal como lo da el README del proyecto; el README también cubre macOS y Linux.

  1. Entorno virtual, dependencias y el navegador Chromium para Playwright

    py -3.13 -m venv .venv
    .\.venv\Scripts\Activate.ps1
    python -m pip install -r requirements.txt
    python -m playwright install chromium
  2. Recoge los primeros 50 libros

    python main.py --limit 50
  3. Otro catálogo, con tu propio perfil de sitio

    python main.py --profile my_site.json --limit 20
Pruebas que puedes ejecutar
python -m pip install -r requirements-dev.txt
python -m pytest
Limitaciones conocidas

Funciona con catálogos cuyos productos están en el HTML de la página y se paginan con enlaces. Sin inicios de sesión, captchas ni scroll infinito.

Servicios

Dos tipos de trabajo: sitios web en tres paquetes y herramientas en Python que manejan datos. El precio depende del alcance, así que cada proyecto empieza con una conversación breve.

Desarrollo web

Tres paquetes que se diferencian en alcance, diseño e interacción, no solo en tamaño. Ninguno necesita backend.

Qué incluye cada paquete de sitio web
EssentialProfessionalSignature
Ideal paraUna cafetería, una tienda o un profesional que necesita una presencia clara y una forma fácil de ser contactadoUn hotel, una clínica o un negocio con varios servicios que necesitan su propio espacioUna marca que quiere que su web forme parte de cómo la recuerdan
Páginas y seccionesUna página con hasta seis seccionesHasta cinco páginas, o una página larga con hasta diez seccionesUna página principal de experiencia y hasta cuatro páginas de apoyo
DiseñoUn diseño limpio adaptado a los colores, tipografías y fotos de tu marcaUn diseño a medida para tu marca, con componentes propiosDirección artística original: un concepto visual creado para tu marca
InteraccionesEnlaces para llamarte, escribirte o encontrarte en un mapaUna galería de imágenes con visor a pantalla completa, y páginas para cada servicioInteracciones diseñadas para tu contenido, como una historia que avanza al desplazarse
AnimaciónEntradas sutiles al desplazarse por la páginaAnimaciones coordinadas al desplazarse y entre seccionesAnimación elaborada guiada por el desplazamiento y microinteracciones propias, con una versión de movimiento reducido
ContactoUn enlace a tu correo o a WhatsAppUn formulario de contacto; si quieres un servicio externo de formularios, su coste va aparteComo en Professional
PrecioSegún el alcance del proyectoSegún el alcance del proyectoSegún el alcance del proyecto
Quiero una web así: EssentialQuiero una web así: ProfessionalQuiero una web así: Signature
  • Essential

    Ideal para
    Una cafetería, una tienda o un profesional que necesita una presencia clara y una forma fácil de ser contactado
    Páginas y secciones
    Una página con hasta seis secciones
    Diseño
    Un diseño limpio adaptado a los colores, tipografías y fotos de tu marca
    Interacciones
    Enlaces para llamarte, escribirte o encontrarte en un mapa
    Animación
    Entradas sutiles al desplazarse por la página
    Contacto
    Un enlace a tu correo o a WhatsApp
    Precio
    Según el alcance del proyecto
    Quiero una web así: Essential
  • Professional

    Ideal para
    Un hotel, una clínica o un negocio con varios servicios que necesitan su propio espacio
    Páginas y secciones
    Hasta cinco páginas, o una página larga con hasta diez secciones
    Diseño
    Un diseño a medida para tu marca, con componentes propios
    Interacciones
    Una galería de imágenes con visor a pantalla completa, y páginas para cada servicio
    Animación
    Animaciones coordinadas al desplazarse y entre secciones
    Contacto
    Un formulario de contacto; si quieres un servicio externo de formularios, su coste va aparte
    Precio
    Según el alcance del proyecto
    Quiero una web así: Professional
  • Signature

    Ideal para
    Una marca que quiere que su web forme parte de cómo la recuerdan
    Páginas y secciones
    Una página principal de experiencia y hasta cuatro páginas de apoyo
    Diseño
    Dirección artística original: un concepto visual creado para tu marca
    Interacciones
    Interacciones diseñadas para tu contenido, como una historia que avanza al desplazarse
    Animación
    Animación elaborada guiada por el desplazamiento y microinteracciones propias, con una versión de movimiento reducido
    Contacto
    Como en Professional
    Precio
    Según el alcance del proyecto
    Quiero una web así: Signature

Todos los paquetes incluyen diseño adaptable, SEO básico, accesibilidad y un sitio listo para publicar como archivos estáticos.

No se incluye, salvo que se acuerde aparte: backend, tienda en línea, gestor de contenidos ni cuentas de usuario.

Ver mi sitio y las demos conceptuales en Desarrollo web

Python, datos y automatización

Trabajos freelance en las mismas áreas que mis proyectos en Python: herramientas para tus datos y tu proceso.

  • Herramientas de importación y revisión de datos

    Subir archivos CSV, Excel o PDF, validar cada fila, marcar duplicados y que una persona apruebe el resultado antes de guardarlo.

  • Scraping web a Excel o CSV

    Recoger campos concretos de páginas que se pueden consultar y entregar hojas de cálculo limpias y sin duplicados.

  • APIs y aplicaciones web pequeñas

    Backends con FastAPI y PostgreSQL que validan la entrada y evitan duplicados, conectados a una interfaz en Next.js.

  • Limpieza de datos y automatización de hojas de cálculo

    Convertir pasos manuales repetidos en un script: números leídos con exactitud, valores normalizados y Excel con formato.

Ver los proyectos en Python, datos y automatización

Cómo trabajamos

Cuatro pasos, desde tu primer mensaje hasta la entrega.

  1. Una primera conversación

    Me cuentas qué le quita tiempo a tu equipo o qué necesita hacer tu web. Pregunto lo necesario para entender el problema antes de proponer nada.

  2. Una propuesta por escrito

    Antes de empezar recibes por escrito qué voy a entregar, qué incluye y qué no.

  3. Un desarrollo que puedes revisar

    Mientras trabajo te comparto avances que puedes abrir y comprobar, para que veas que va en la dirección correcta.

  4. La entrega

    Recibes el código y la documentación acordados en la propuesta.

Sobre mí

Si en tu negocio alguien copia datos de un Excel o un PDF a otro sistema, los revisa a mano y aun así se cuelan errores, puedo automatizar ese trabajo. Desarrollo herramientas que comprueban la información, ordenan el proceso y te dejan revisar los datos antes de guardarlos.

También hago páginas web profesionales, para que tus clientes entiendan qué ofreces y cómo contactarte.

Soy Luis Pimentel, desarrollador Python junior. Trabajo en remoto desde Potosí, Bolivia, con Python, FastAPI y PostgreSQL, y con tecnologías frontend como Next.js cuando el proyecto necesita interfaz. Hablo español como lengua materna.

Herramientas que uso

Solo lo que estos proyectos usan de verdad, y dónde puedes ver cada herramienta.

Lenguajes
  • PythonQuoteFlow, LeadFlow, Book Data Extractor Pro
  • TypeScriptQuoteFlow, LeadFlow
  • JavaScriptQuoteFlow
Frameworks y librerías
  • FastAPIQuoteFlow, LeadFlow
  • Pydantic 2QuoteFlow, LeadFlow
  • SQLAlchemy 2QuoteFlow, LeadFlow
  • AlembicQuoteFlow
  • Next.js 16 y React 19QuoteFlow, LeadFlow
  • Playwright (scraping)Book Data Extractor Pro
  • openpyxlQuoteFlow, Book Data Extractor Pro
  • pypdfQuoteFlow
Bases de datos
  • PostgreSQL 18QuoteFlow, LeadFlow
Herramientas
  • pytestQuoteFlow, LeadFlow, Book Data Extractor Pro
  • Playwright TestLeadFlow
  • node:testQuoteFlow
  • RuffQuoteFlow, LeadFlow
  • Docker ComposeQuoteFlow, LeadFlow
  • GitHub ActionsBook Data Extractor Pro
  • n8nQuoteFlow
  • Git y GitHubQuoteFlow, LeadFlow, Book Data Extractor Pro

Preguntas frecuentes

¿Quién registra el dominio y dónde se publica el sitio?

Lo acordamos en la propuesta escrita, antes de empezar. Los sitios que hago son archivos estáticos, así que se pueden publicar en muchos alojamientos, incluidos los gratuitos para sitios estáticos, como GitHub Pages.

¿Qué necesito aportar?

Para un sitio web: tus textos, tu logo, las fotos que quieras usar y los datos de tu negocio, como qué ofreces, tu horario, dónde estás y cómo contactarte. Para una herramienta de datos: archivos de ejemplo con los datos reales eliminados o sustituidos, y una descripción breve de qué haces hoy con ellos. Por favor, no envíes contraseñas ni datos personales sensibles.

¿Cuánto tardas en responder y en qué idioma?

Respondo en un plazo de 24 horas. Trabajo en español; en inglés, la comunicación será principalmente por escrito.

Contacto

Cuéntame qué necesitas. El formulario te prepara un correo; desde esta página no se envía nada.

Disponible para proyectos freelance, en remoto.

Con unas líneas sobre tu negocio o tus datos es suficiente.

Desde esta página no se envía nada: tu aplicación de correo se abre con el mensaje listo, o puedes copiarlo.

Qué pasa después

  1. Tu aplicación de correo se abre con el mensaje listo, o lo copias.
  2. Lo envías desde tu propio correo; desde esta página no se envía nada.
  3. Respondo en un plazo de 24 horas para preguntarte lo que necesite y organizar una primera conversación.

Trabajo en español; en inglés, la comunicación será principalmente por escrito. Estoy en Potosí, Bolivia (UTC−4).

O escribe directamente

Por favor, no incluyas contraseñas, credenciales ni datos personales sensibles en tu primer mensaje.

¿Me encontraste en Upwork? Mantén toda la comunicación en los mensajes de Upwork hasta que haya un contrato, como exigen sus condiciones.